Java 八股文
一、JavaSE - 一阶段
1.1 重点
- 集合
- 线程
- JVM
1.2 Java集合
1.2.1 集合体系
- Collection
- List
- Vector
- ArrayList
- LinkedList
- Set
- HashSet
- LinkedHashSet
- TreeSet
- Map
- HashMap(重要)
- LinkedHashMap
- TreeMap
1.2.1 List集合体系
ArrayList/Vector的底层原理
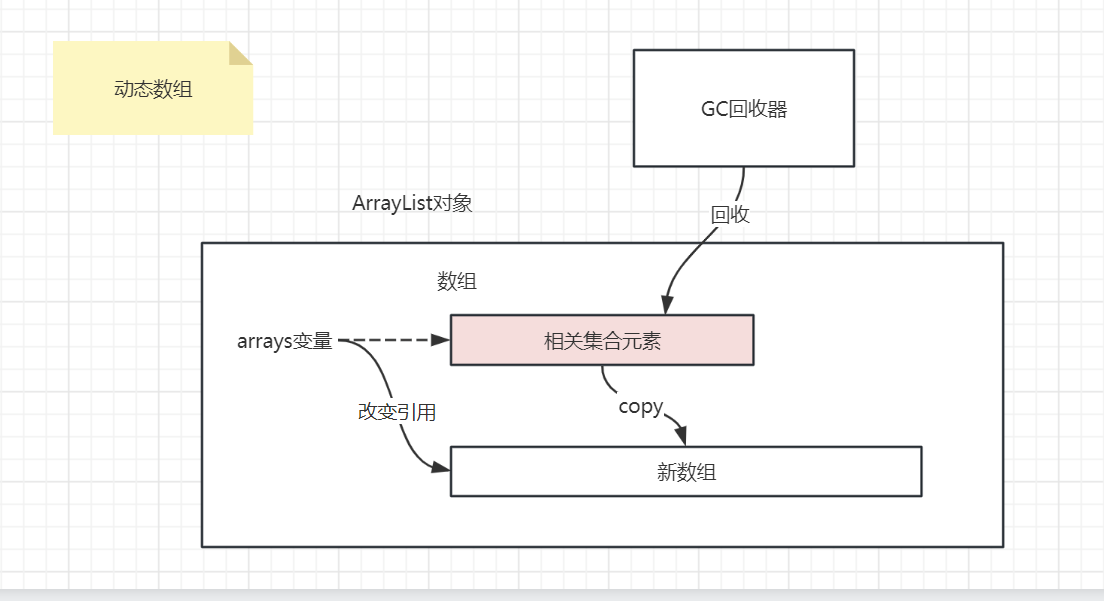
都是基于动态数组来实现,所谓的动态数组,就是当底层数组长度达到容量之后,会创建一个长度更长的数组,将原始数组的元素拷贝到新数组中,完成扩容。
 ArrayList和Vector的区别
- **线程安全的角度 - **ArrayList是线程不安全的,Vector是线程安全的
- **版本角度 - **Vector是JDK1.0的产物,ArrayList是随着JDK1.2的集合体系诞生的
- **懒加载 - **Vector是初始化时底层直接创建一个长度为10的数组(立即加载),ArrayList从JDK7之后,被设置为懒加载,当添加第一个元素时,底层才会初始化长度为10的数组
ArrayList的底层源码
//空数组
private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {};

//底层Object类型的数组
transient Object[] elementData;

//集合中元素的个数,默认为0
private int size;

//构造方法
public ArrayList() {
    //将elementDate变量,指向一个空数组
    this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA;
}
//将元素e添加到集合中
public boolean add(E e) {
    //判断是否需要扩容,参数表示当前至少需要的容量
    ensureCapacityInternal(size + 1);  // Increments modCount!!
    //将元素e放入数组的合适位置中,同时元素的数量自增
	//该行代码有线程安全问题
    elementData[size++] = e;
    return true;
}
private void grow(int minCapacity) {
    //记录底层数组的当前容量(旧容量)
    int oldCapacity = elementData.length;
    //新容量 = 旧容量 + 旧容量 * 0.5 (按1.5倍扩容)
    int newCapacity = oldCapacity + (oldCapacity >> 1);
	//边界处理
    if (newCapacity - minCapacity < 0)
        newCapacity = minCapacity;
    if (newCapacity - MAX_ARRAY_SIZE > 0)
        newCapacity = hugeCapacity(minCapacity);
    //Arrays.copyOf - 基于newCapacity容量创建一个新数组,
	//				  并且将elementData数组中的元素拷贝到新数组中,返回新数组
	//该方法底层是通过C实现,极大的提高了数组拷贝的效率
    elementData = Arrays.copyOf(elementData, newCapacity);
}
LinkedList的底层原理
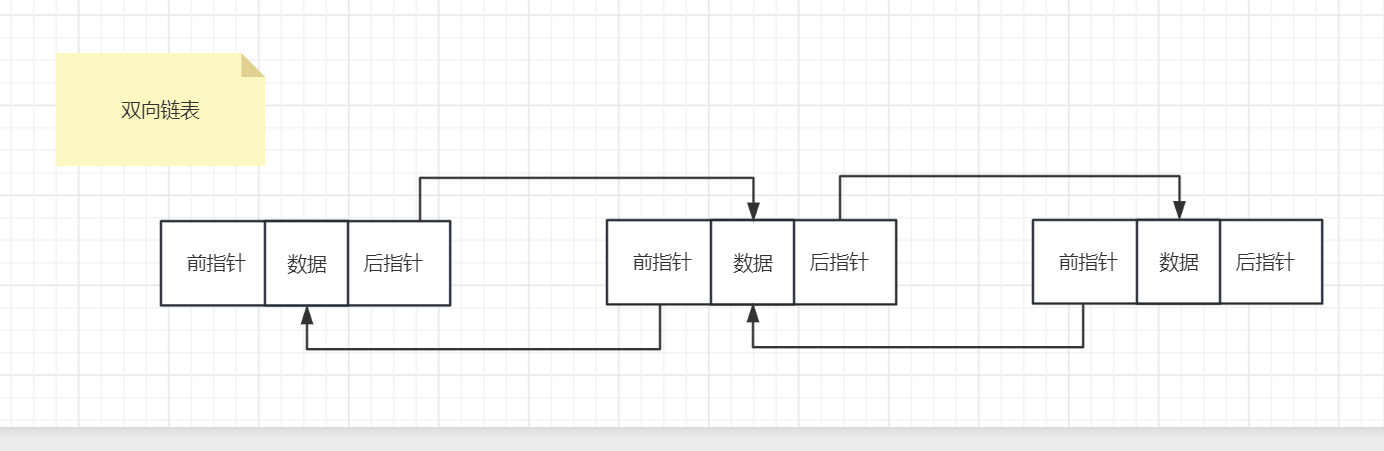
底层是基于双向链表实现的 双向链表在内存中的地址是不连续的
 思考
双向链表中的节点以及节点的关系,如何用Java代码表示
//节点类
class Node<T>{
    Node pre; //前指针
    T data; //数据部分
    Node next; //后指针
}

//实现两个节点互相前后指向
Node startNode = new Node();
Node endNode = new Node();
startNode.next = endNode;
endNode.pre = startNode;
LinkedList的核心源码
private static class Node<E> {
    E item;
    Node<E> next;
    Node<E> prev;

    Node(Node<E> prev, E element, Node<E> next) {
        this.item = element;
        this.next = next;
        this.prev = prev;
    }
}
transient int size = 0;

/**
* 永远指向双向链表的第一个节点
*/
transient Node<E> first;

/**
* 永远指向双向链表的最后一个节点
*/
transient Node<E> last;
public boolean add(E e) {
    linkLast(e);
    return true;
}

//将元素e 链接到链表的最后
void linkLast(E e) {
    //创建一个变量l 指向last(最后一个节点)
    final Node<E> l = last;
    //创建一个新节点,上一个节点,指向l
    final Node<E> newNode = new Node<>(l, e, null);
    //新节点变成最后一个节点
    last = newNode;
    if (l == null)
        //l为空,表示newNode是整个链表中的第一个节点
        //first也指向newNode
        first = newNode;
    else
        //l不为空,表示追加
        //l的下一个指针指向newNode
        l.next = newNode;
    size++;
    modCount++;
}
public E remove(int index) {
    //检测下标是否越界
    checkElementIndex(index);
    //删除index位置的元素
    return unlink(node(index));
}


//找到index位置的节点Node对象
Node<E> node(int index) {
    //判断index在整个链表靠后还是靠前的位置
    if (index < (size >> 1)) {
        //如果index比较靠前,则从first开始往后找
        Node<E> x = first;
        for (int i = 0; i < index; i++)
            x = x.next;
        return x;
    } else {
        //如果index比较靠后,则从last开始往前找
        Node<E> x = last;
        for (int i = size - 1; i > index; i--)
            x = x.prev;
        return x;
    }
}

//断开节点x的前后指针
E unlink(Node<E> x) {
    //记录节点x的数据部分
    final E element = x.item;
    //记录节点x的下一个节点
    final Node<E> next = x.next;
    //记录节点x的上一个节点
    final Node<E> prev = x.prev;

    if (prev == null) {
        //如果x是第一个节点,则让下一个节点变成first
        first = next;
    } else {
        //让上一个节点的下指针,指向下一个节点
        prev.next = next;
        x.prev = null;
    }

    if (next == null) {
        last = prev;
    } else {
        next.prev = prev;
        x.next = null;
    }

    x.item = null;
    size--;
    modCount++;
    return element;
}
ArrayList Vs LinkedList
public static void main(String[] args) {

    //查询的性能
    //	- 头部(性能差不多 - 很快)
    //	  中间(ArrayList性能远远高于LinkedList)
    //	  尾部(性能差不多 - 很快)
    //插入的性能
    //  - 头部(LinkedList性能要略高于ArrayList)
    //    中间(ArrayList性能高于LinkedList)
    //	  尾部(性能差不多 - 很快)
    List<Integer> list1 = new ArrayList<>();
    List<Integer> list2 = new LinkedList<>();

    //初始化10W个元素
//        for (int i = 0; i < 100000; i++) {
//            list1.add(i);
//            list2.add(i);
//        }

    //10w次获取头部
    long begin = System.currentTimeMillis();
    int middle = list1.size() >> 1;
    for (int i = 0; i < 100000; i++) {
        list1.add(i);
    }
    long end = System.currentTimeMillis();
    System.out.println("ArrayList操作10W次的耗时:" + (end - begin));

    long begin2 = System.currentTimeMillis();
    int middle2 = list2.size() >> 1;
    for (int i = 0; i < 100000; i++) {
        list2.add(i);
    }
    long end2 = System.currentTimeMillis();
    System.out.println("LinkedList操作10W次的耗时:" + (end2 - begin2));

}
- ArrayList查询是一个O(1)时间复杂度的操作,LinkedList越往中间查询性能越差。因此,如果是在查询比较多的场景下,应该选择ArrayList。
- ArrayList插入/删除,越靠前查询性能越慢,但是底层基于C进行了优化,插入性能基本还OK。LinkedList越靠近两端的插入/删除性能越好,越靠近中间性能越差,甚至要远远低于ArrayList。
- 除非需要频繁的往头部插入元素,否则我们都应该选择ArrayList
1.2.2 Set集合体系
Set体系的实现,底层都是基于Map集合的。当添加一个元素时,该元素会作为Key放入的Map集合中,value放入一个默认的Object对象(没有任何作用的)。因此Set集合的特性和对应的Map集合中的key的特性是完全相同的。
HashSet
底层就是HashMap,特点 - 元素无序且不可重复
LinkedHashSet
底层是LinkedHashMap, 特点 - 元素有序(插入顺序)且不可重复
TreeSet
底层是TreeMap,特点 - 元素有序(字典顺序)且不可重复
1.2.3 Map集合体系
哈希表
哈希碰撞、扩容、填充因子
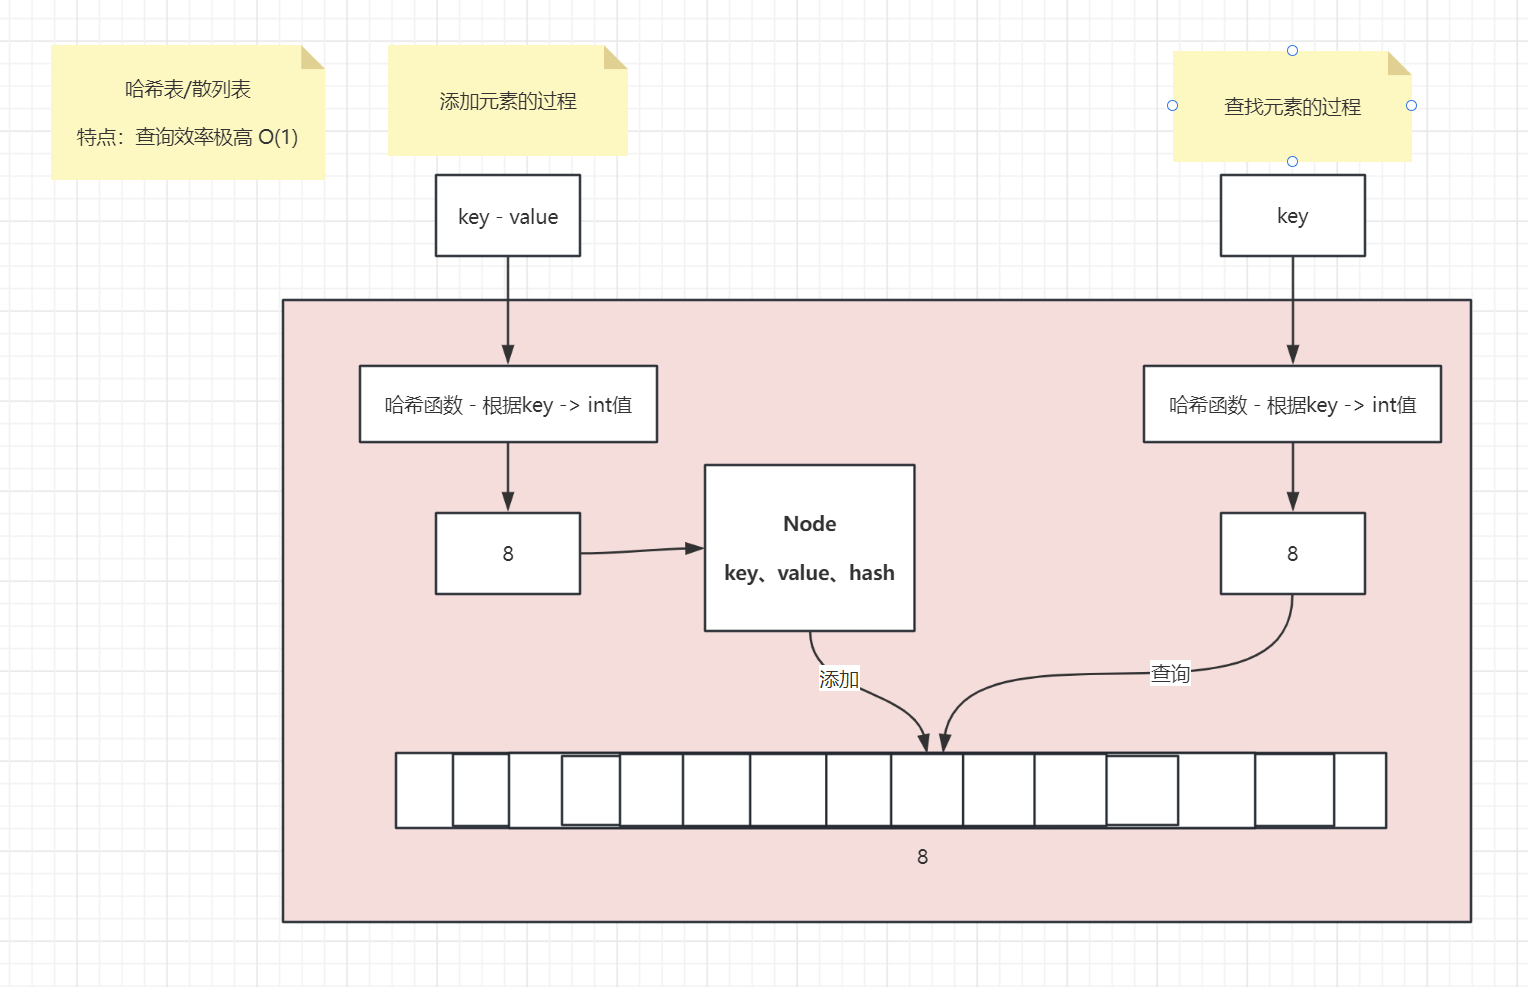
哈希表主要用于存放key-value类型的键值对,可以通过key快速的找到value的值。核心的结构是一个数组,当存放key-value时,会根据一个哈希函数,通过key,计算到一个数组的下标值,然后将key和value封装成一个对象,放入到指定下标的数组位置(哈希桶)。对于这种存放元素的数组,统称为哈希表
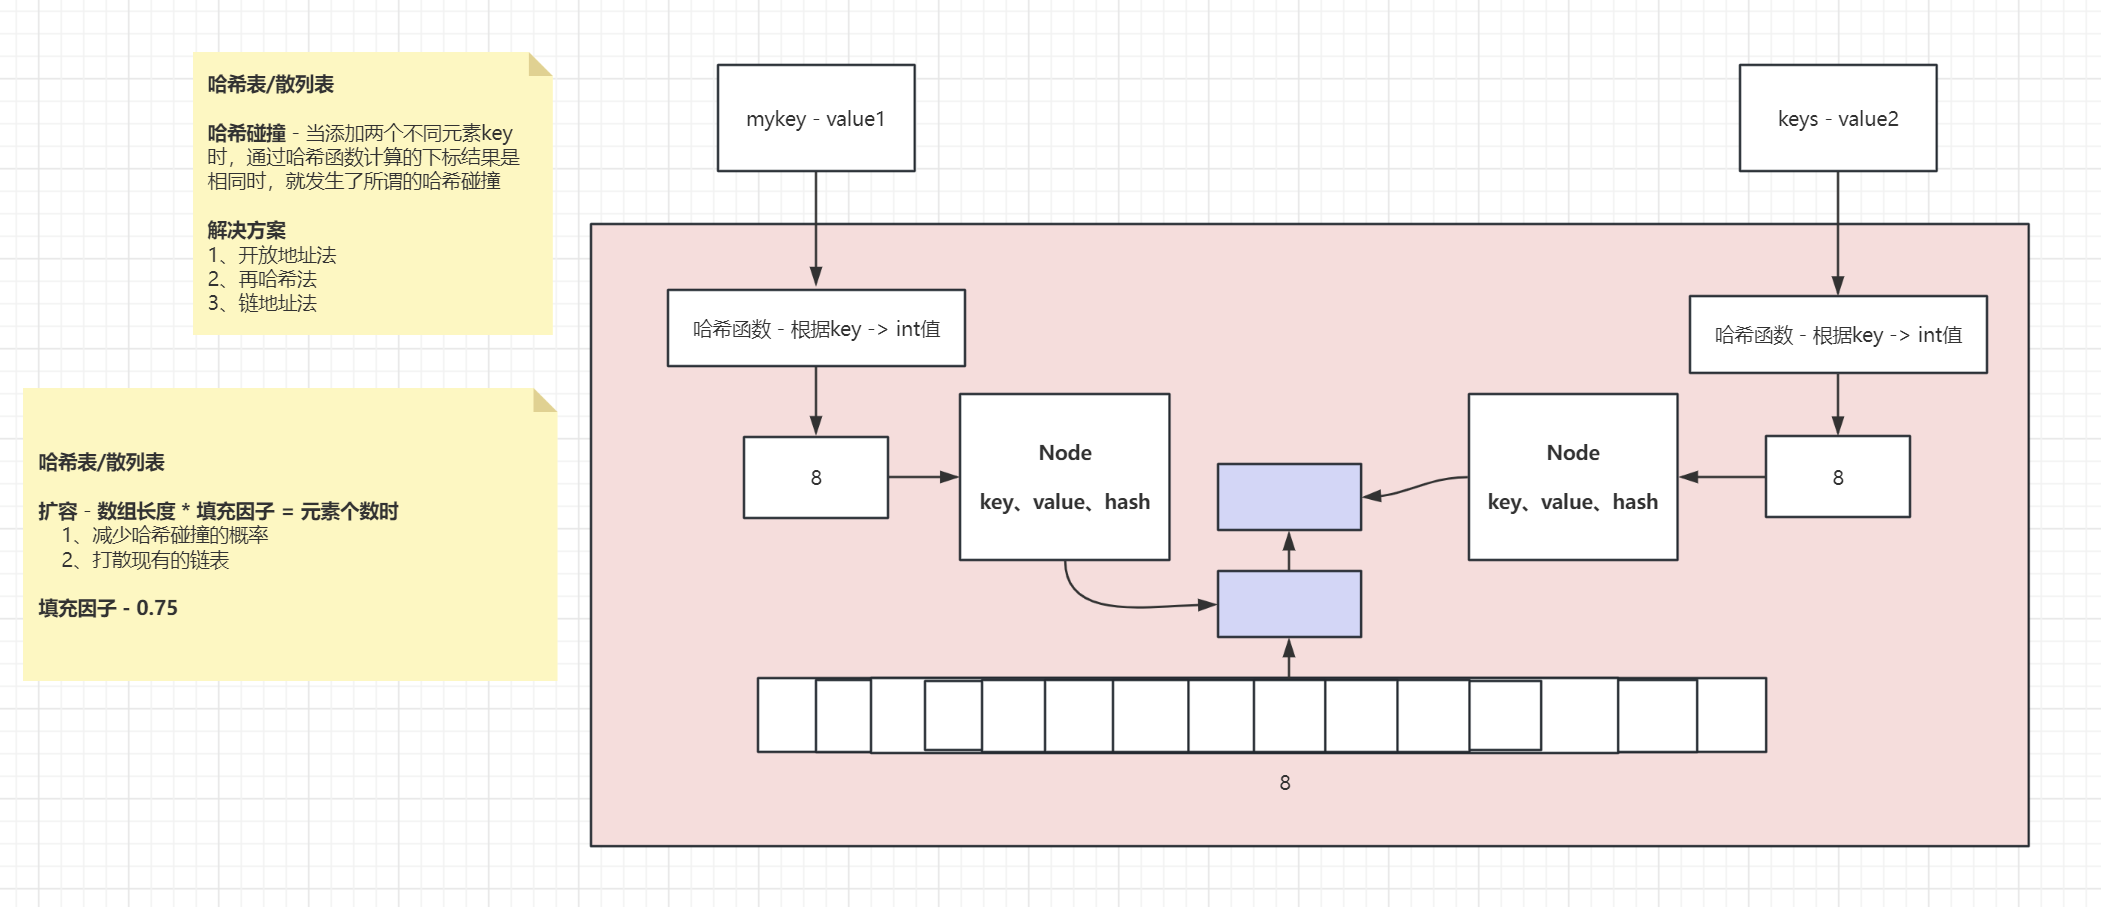
如何在数组中,放入一个单向链表 ?(解决哈希碰撞的问题 - 链地址法)
//链表的节点对象
class Node<K,V> {
    //数据部分
	K key;
    V value;
    //下一个节点的引用
    Node next;
}


//哈希表的底层数组
Node[] hashTable = .....;
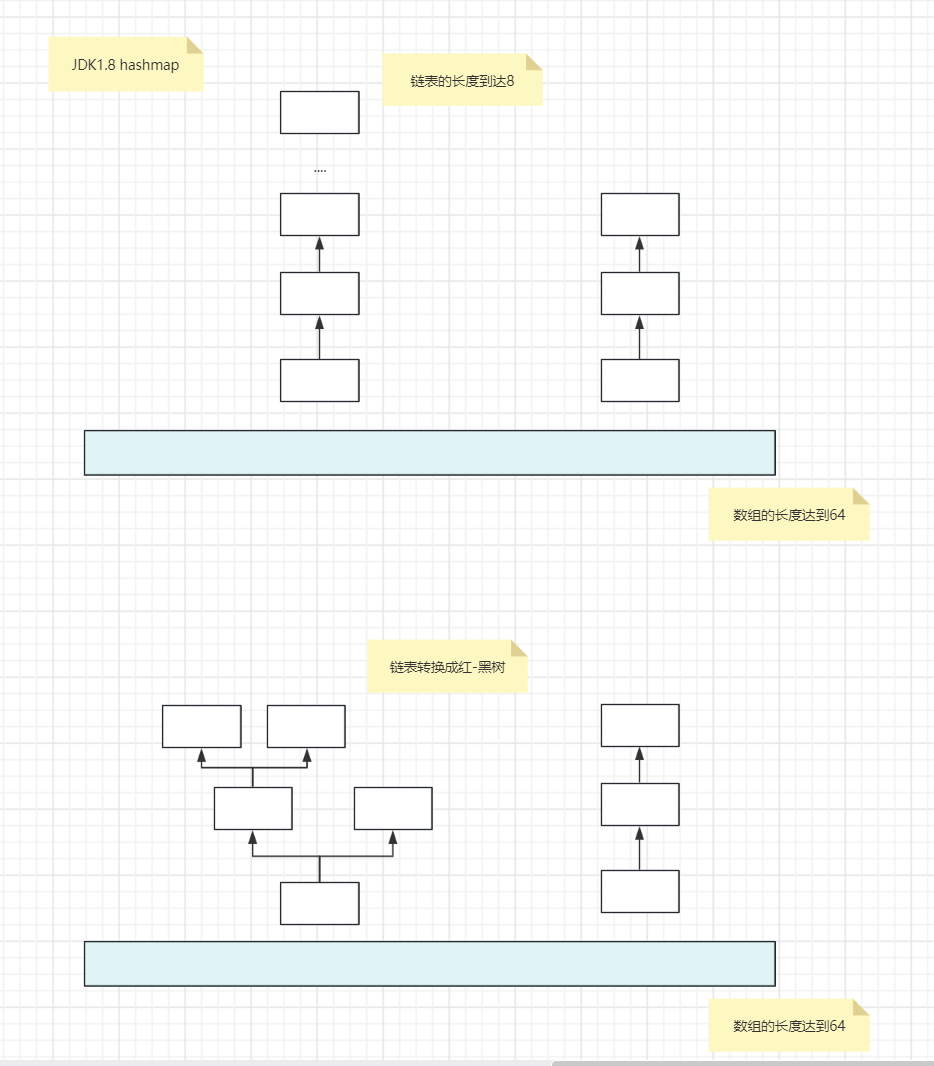
JDK1.8之后HashMap的底层变化
- 底层的哈希表变为懒加载模式
- 链表由头插变成了尾插
- 引入了红黑树解决哈希碰撞
- 当一个链表长度到达8 并且 数组的长度达到64时,该位置的链表就会转换成红黑树
- 如果一个链表长度达到8 但是数组长度没有达到64,只会触发哈希表的扩容
二叉搜索树
当一个二叉树,左子树的所有节点都小于当前节点,右子树的所有节点都大于当前节点,并且二叉树中,每个节点都准寻这样的规则,那么这颗二叉树就成为二叉搜索树 缺点:树的失衡,一旦树失衡,查询效率极低
红-黑树(red-black tree)
简单来说,红-黑树就是一个平衡的二叉搜索树。它有一套红黑规则,只要准寻了红黑规则,这颗二叉搜索树就是平衡的(相对)
HashMap的底层源码
static final float DEFAULT_LOAD_FACTOR = 0.75f;

public HashMap() {
    //设置填充因子
    this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted
}
static class Node<K,V> implements Map.Entry<K,V> {
    //代表当前key算出的哈希值(不是下标), hash & (数组长度 - 1)
    final int hash;
    //key
    final K key;
    //value
    V value;
    //链表中的下一个节点
    Node<K,V> next;

    Node(int hash, K key, V value, Node<K,V> next) {
        this.hash = hash;
        this.key = key;
        this.value = value;
        this.next = next;
    }

    public final K getKey()        { return key; }
    public final V getValue()      { return value; }
    public final String toString() { return key + "=" + value; }

    public final int hashCode() {
        return Objects.hashCode(key) ^ Objects.hashCode(value);
    }

    public final V setValue(V newValue) {
        V oldValue = value;
        value = newValue;
        return oldValue;
    }

    //重写了eqauls方法,并且比较key和value是否相等
    public final boolean equals(Object o) {
        if (o == this)
            return true;
        if (o instanceof Map.Entry) {
            Map.Entry<?,?> e = (Map.Entry<?,?>)o;
            if (Objects.equals(key, e.getKey()) &&
                Objects.equals(value, e.getValue()))
                return true;
        }
        return false;
    }
}
//默认哈希表的容量,默认16
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16

//哈希表的最大容量
static final int MAXIMUM_CAPACITY = 1 << 30;

//默认填充因子
static final float DEFAULT_LOAD_FACTOR = 0.75f;

//链表转红-黑树的长度
static final int TREEIFY_THRESHOLD = 8;

//红-黑树转回链表的长度
static final int UNTREEIFY_THRESHOLD = 6;

//转换成红黑树需要数组的最小长度
static final int MIN_TREEIFY_CAPACITY = 64;


//【核心】 - 底层的哈希表
transient Node<K,V>[] table;


//哈希表的当前元素个数
transient int size;


//需要扩容的元素个数 threshold = 数组的长度 * loadFactor
int threshold;

//当前的填充因子
final float loadFactor;
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
/**
* 保存key - value
*/
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

/**
 * Implements Map.put and related methods.
 *
 * @param 根据key计算的一个hash值
 * @param key
 * @param value
 * @param 当key相同时,value是否覆盖,true表示不覆盖,false表示覆盖
 * @param evict if false, the table is in creation mode.
 * @return previous value, or null if none
 */
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {
    //tab代表当前的哈希表
    Node<K,V>[] tab;
    //表示当前哈希桶的第一个元素
    Node<K,V> p;
    //n代表哈希表的长度
    //i计算出的哈希桶的下标
    int n, i;
    if ((tab = table) == null || (n = tab.length) == 0)
        //如果哈希表还未初始化,则调用resize()方法进行扩容(兼容初始化)
        n = (tab = resize()).length;

    //开始计算哈希桶的位置
    //hash & (n - 1) = [0 ~ n-1]
    //i就算计算出来的哈希桶的下标
    //p表示当前哈希表的下标i中的第一个元素
	/*
     	i = (n-1) & hash;
        p = tab[i];
        if(p == null){}
    */
    if ((p = tab[i = (n - 1) & hash]) == null)
        //说明当前这个位置没有被占用,没有发生哈希碰撞
        //思考?为啥不直接调用new Node()
        tab[i] = newNode(hash, key, value, null);
    else {
        //说明发生了哈希碰撞
        Node<K,V> e; K k;
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            //说明添加的数据key和哈希桶的第一个元素key相等
            e = p;
        else if (p instanceof TreeNode)
            //说明该哈希桶的位置,存放的是一个红-黑树,调用红黑树的方法进行元素的添加
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        else {
            //说明当前哈希桶的位置是一个链表
            for (int binCount = 0; ; ++binCount) {
                if ((e = p.next) == null) {
                    //走到了链表的最后,没有发现key相同的节点,新建一个节点,链入链表的末尾(尾插)
                    p.next = newNode(hash, key, value, null);
                    //判读当前哈希桶是否需要转红-黑树
                    if (binCount >= TREEIFY_THRESHOLD - 1) //
                        //转换红黑树(还需要根据 数组的长度决定是否转树,如果 长度没到64,则进行扩容)
                        treeifyBin(tab, hash);
                    break;
                }
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;
                p = e;
            }
        }

        //如果e不为空,表示找到了相同的key
        if (e != null) { // existing mapping for key
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null)
                //将value覆盖到哈希桶相同的节点的位置
                e.value = value;
            afterNodeAccess(e);
            return oldValue;
        }
    }
    ++modCount;
    //size自增
    if (++size > threshold)
        //如果元素个数超过了阈值,就要扩容
        resize();
    //预留的拓展方法
    afterNodeInsertion(evict);
    return null;
}
final Node<K,V>[] resize() {
    //记录旧的哈希表
    Node<K,V>[] oldTab = table;
    //记录旧的哈希表的容量
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    //记录旧的扩容阈值
    int oldThr = threshold;
    int newCap, newThr = 0;

    if (oldCap > 0) {
        //判断旧容量是否超过0,判断哈希表是否已经初始化
        if (oldCap >= MAXIMUM_CAPACITY) {
            //如果哈希表已经达到了最大容量,则不再扩容,直接返回旧的哈希表
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }
        //计算新容量的大小 = 旧容量 * 2
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                 oldCap >= DEFAULT_INITIAL_CAPACITY)
            newThr = oldThr << 1; // double threshold
    }
    else if (oldThr > 0) // initial capacity was placed in threshold
        newCap = oldThr;
    else {
        //哈希表初始化的设置
        newCap = DEFAULT_INITIAL_CAPACITY;
        //新的元素阈值 = 填充因子 * 数组容量
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }

    if (newThr == 0) {
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                  (int)ft : Integer.MAX_VALUE);
    }
    threshold = newThr;
    @SuppressWarnings({"rawtypes","unchecked"})
    //创建一个新的哈希表
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
    table = newTab;
    if (oldTab != null) {
        //旧的哈希表不为空时,需要进行元素的移位
        for (int j = 0; j < oldCap; ++j) {
            Node<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;
                if (e.next == null)
                    newTab[e.hash & (newCap - 1)] = e;
                else if (e instanceof TreeNode)
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                else { // preserve order
                    Node<K,V> loHead = null, loTail = null;
                    Node<K,V> hiHead = null, hiTail = null;
                    Node<K,V> next;
                    do {
                        next = e.next;
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                loTail.next = e;
                            loTail = e;
                        }
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);
                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
LinkedHashMap
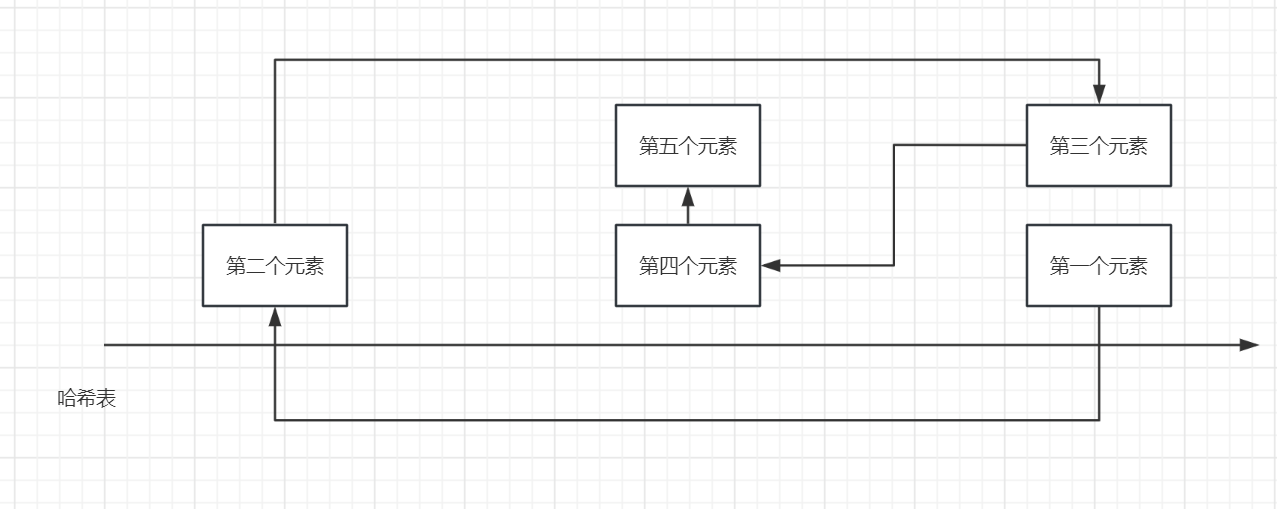
特点:key有序(插入顺序)且不可重复 底层的实现原理:HashMap + 链表(维护插入顺序),LinkedHashMap底层需要额外维护一个双向链表,所以添加元素的性能要略低于HashMap,但是因为有这个双向链表的存在,在遍历整个哈希表时,性能反而要高于HashMap
 LinkedHashMap底层源码
//重写父类(HashMap)的newNode方法,创建一个新的节点,这个节点可以维护一个双向链表
Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) {
    LinkedHashMap.Entry<K,V> p =
        new LinkedHashMap.Entry<K,V>(hash, key, value, e);
    linkNodeLast(p);
    return p;
}
TreeMap
特点:**key有序(字典顺序)**且不可重复 底层原理:红-黑树,底层判断key是否相等不是用==,也不是用eqauls,而是基于比较器是否返回0决定的
TreeMap<Integer, String> treeMap = new TreeMap<>(new Comparator<Integer>() {
    @Override
    public int compare(Integer o1, Integer o2) {
        return 0;
    }
});
1.2.4 线程安全的集合体系
之前的集合在多线程场景下会有什么问题?
- 多线程同时添加原始时,可能造成元素覆盖的情况
- 多线程操作集合,也可能引起重复扩容的问题
- HashMap在重复扩容时,JDK1.7之前有可能形成环链
- .........
线程安全的集合
- 使用传统的线程安全的集合(Vector、Hashtable)不推荐
- 调用Collections工具类下的,synchronizedXxxx方法,传入一个线程不安全的集合,返回线程安全的集合
- 直接调用JUC包的集合(java.util.concurrent)
CopyOnWriteArrayList集合
- 是一个线程安全的List集合实现类(线程安全版的ArrayList)
- 底层通过写入时复制 + 同步锁的方式,来实现线程安全,同时隔离了读写并发的问题,以此来提高读的效率
- 对于读多写少的场景很适合
//同步锁 + 写入时复制
public boolean add(E e) {
    final ReentrantLock lock = this.lock;
    lock.lock();
    try {
        Object[] elements = getArray();
        int len = elements.length;
        //将原有的集合拷贝一份,当前线程写入到拷贝的数组中,不影响原有数组的读取
        Object[] newElements = Arrays.copyOf(elements, len + 1);
        newElements[len] = e;
        setArray(newElements);
        return true;
    } finally {
        lock.unlock();
    }
}
ConcurrentHashMap集合
- 线程安全版的HashMap
- JDK1.7以及之前,底层是基于分段锁实现,保证线程安全
- JDK1.8以及之后,底层基于CAS + 自旋 + 同步锁锁桶的方式,保证线程安全
//添加元素的方法
final V putVal(K key, V value, boolean onlyIfAbsent) {
    //避免null值的操作
    if (key == null || value == null) throw new NullPointerException();
    //通过哈希函数计算key的哈希值
    int hash = spread(key.hashCode());
    int binCount = 0;
    //循环 = 自旋,初始化tab指向当前的哈希表

    for (Node<K,V>[] tab = table;;) {
        //f就是当前计算出的哈希桶的第一个节点
        Node<K,V> f;
        //n 表示哈希表的容量
        //i 表示计算出的哈希桶的下标
        //fh 是一个标识位
        int n, i, fh;
        if (tab == null || (n = tab.length) == 0)
            //哈希表没有初始化,调用初始化哈希表的方法
            tab = initTable();
        //i = (n - 1) & hash - 根据哈希值,计算哈希表的下标
        //tabAt(tab, i = (n - 1) & hash)) = tab[i] (这个写法保证了线程的可见性)
        else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
            //表示哈希桶i的位置没有元素,可以直接添加元素
            if (casTabAt(tab, i, null,
                         new Node<K,V>(hash, key, value, null)))
                break;                   // no lock when adding to empty bin
        }

        //(fh = f.hash) == MOVED - 获取当前哈希桶i的第一个元素f的哈希值,赋值给fh,但是如果 哈希值==MOVED
        //说明当前这个哈希桶正在经历扩容
        else if ((fh = f.hash) == MOVED)
            //当前线程会加入扩容的功能,帮助其他线程快速完成哈希表的扩容
            tab = helpTransfer(tab, f);
        else {
            //说明发生了哈希碰撞,锁住下标为i的第一个元素f,保证加入时线程安全
            V oldVal = null;
            synchronized (f) {
                if (tabAt(tab, i) == f) {
                    if (fh >= 0) {
                        binCount = 1;
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            Node<K,V> pred = e;
                            if ((e = e.next) == null) {
                                pred.next = new Node<K,V>(hash, key,
                                                          value, null);
                                break;
                            }
                        }
                    }
                    else if (f instanceof TreeBin) {
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                                       value)) != null) {
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                }
            }
            if (binCount != 0) {
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i);
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount);
    return null;
}
1.3 多线程
1.3.1 线程池
//单线程的线程池
ExecutorService executorService = Executors.newSingleThreadExecutor();
//固定线程的线程池
ExecutorService executorService2 = Executors.newFixedThreadPool(5);
//缓存线程池 - 多线程数不做限制的
ExecutorService executorService3 = Executors.newCachedThreadPool();
//具有定时任务功能的线程池
ScheduledExecutorService scheduledExecutorService = Executors.newScheduledThreadPool(5);
为什么阿里规范规定在实际开发过程中,必须由开发者主动创建线程池,而不是采用JDK默认提供的方式?
因为JDK官方默认提供的线程池,底层的阻塞队列都是采用的LinkedBlockingQueue,这个阻塞队列底层是基于链表实现的,链表是没有长度限制的。因此,如果多线程的任务较多,线程数处理不过来时,大量任务会放入阻塞队列中,而阻塞队列没有容量的限制很容易就造成内存溢出。
线程池的相关参数
/**
* corePoolSize - 核心线程数
* maximumPoolSize - 最大线程数(核心线程数 + 非核心线程数)
* keepAliveTime - 最大空闲时间(非核心线程数)
* unit - 空闲时间的单位
* workQueue - 阻塞队列 ????
* threadFactory - 线程工厂 - 决定了线程的创建方式
* RejectedExecutionHandler - 拒绝策略
*/
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory,
                          RejectedExecutionHandler handler)
线程池的工作机制
public void execute(Runnable command) {
    if (command == null)
        throw new NullPointerException();


    int c = ctl.get();
    //workerCountOf(c) - 获取当前正在工作的线程数
	//corePoolSize - 核心线程数
    if (workerCountOf(c) < corePoolSize) {
        //核心线程没有创建完成
        //addWorker(command, true) - 创建一个线程并且立刻执行command任务,新创建的线程是否为核心线程
        if (addWorker(command, true))
            return;
        c = ctl.get();
    }
	//表明核心线程数已满
	//isRunning(c) - 如果线程池处于可运行状态
	//workQueue.offer(command) - 将command任务放入阻塞队列,返回true表示放入成功,false表示放入失败
    if (isRunning(c) && workQueue.offer(command)) {
        int recheck = ctl.get();
        if (! isRunning(recheck) && remove(command))
            reject(command);
        else if (workerCountOf(recheck) == 0)
            addWorker(null, false);
    }
    //表明阻塞队列没有放入成功(阻塞队列满了)
    //创建非核心线程执行当前任务
    //如果非核心线程创建失败(最大线程数已满)
    else if (!addWorker(command, false))
        //执行拒绝策略
        reject(command);
}
:::warning 当提交一个新的任务给线程池时,它的运行方式:
- 如果核心线程数没满,则创建一个核心线程,并立刻执行当前任务
- 如果核心线程数满了,则将任务放入阻塞队列(核心线程任务执行完成,会立刻从阻塞队列中获取新的任务执行)
- 如果阻塞队列已满,任务放入失败,创建非核心线程数(非核心 + 核心 <= 最大线程数),并且立刻执行当前任务
- 如果最大线程数已满,则触发**拒绝策略,**处理当前的任务 ::: 拒绝策略
JDK提供的默认拒绝策略(4种):
- new ThreadPoolExecutor.AbortPolicy() - 直接抛出异常
- **new ThreadPoolExecutor.DiscardPolicy() - **直接丢弃当前任务
- new ThreadPoolExecutor.DiscardOldestPolicy() - 丢弃阻塞队列中队头的任务
- new ThreadPoolExecutor.CallerRunsPolicy() - 交给当前线程处理(谁提交的任务谁处理)
为什么线程池底层要设计一个阻塞队列?而不用普通队列?
阻塞队列的核心方法:
- take() - 获取元素,当队列为空时,调用该方法会阻塞当前线程,直到队列中有元素为止
- put() - 添加元素,当队列已满时,调用该方法会阻塞当前线程,直到队列中有空余位置可以放入元素为止
阻塞队列的设计,是为了防止线程池中的线程,执行完任务后,就被销毁。线程池中所有的线程,在执行完任务后,会再次调用阻塞队列的take方法,获取任务,如果 获取到了,继续执行,如果没有获取到,则阻塞当前线程(不会进行销毁状态)
线程池的其他相关方法
//允许核心线程超时  默认为false
threadPoolExecutor.allowCoreThreadTimeOut(true);
//获得线程池中的线程数量
threadPoolExecutor.getPoolSize();
//调用该方法后,线程池会拒绝新的任务,但是会讲正在执行的任务和阻塞队列中的任务执行完成,再结束
threadPoolExecutor.shutdown();
//调用该方法后,表示要立刻结束,但是也不是立刻结束。
//1、会拒接新的请求
//2、会放弃阻塞队列中的所有任务
//3、会尝试中断正在执行的所有任务,如果中断失败仍然会继续执行
//4、返回队列中剩下的任务
threadPoolExecutor.shutdownNow();
1.3.2 ThreadLocal
什么是ThreadLocal?
ThreadLocal是一个线程资源隔离的工具,每个线程都只能访问和修改到自己设置的数据,以此来保证数据的隔离性
ThreadLocal 和 锁的区别?
锁 - 解决资源竞争的问题,多个线程要操作同一份资源,因为有线程安全问题,所有需要锁来保证资源竞争时的一致性问题 ThreadLocal - 解决资源隔离的问题,多个线程需要独立访问自己的资源,每个线程和每个线程之间的操作互不影响时,需要用到ThreadLocal
InheritableThreadLocal子类的特性
//InheritableThreadLocal子类保证了,A线程设置了threadLocal,
//只有A线程以及A线程创建的子线程才可以获得设置的数据
//其他线程无法获得该数据
ThreadLocal threadLocal = new InheritableThreadLocal();

new Thread(() -> {
    //设置了数据
    threadLocal.set(15);
    //自己是可以获得该数据,打印15
    System.out.println("自己的线程:" + threadLocal.get());

    new Thread(() -> {
        //创建的子线程也可以获得数据,打印15
        System.out.println("子线程:" + threadLocal.get());
    }).start();

}).start();
ThreadLocal原理
public void set(T value) {
    //获取当前线程
    Thread t = Thread.currentThread();
    //获取当前线程中的ThreadLocalMap
    ThreadLocalMap map = getMap(t);
    if (map != null)
        //将当前的ThreadLocal对象(this)作为key,记录的数据作为value,放入这个map中
        map.set(this, value);
    else
        //创建一个ThreadLocalMap
        createMap(t, value);
}
//ThreadLocalMap设置key-value
private void set(ThreadLocal<?> key, Object value) {
    //底层的哈希表
    Entry[] tab = table;
    //哈希表的长度
    int len = tab.length;
    //当前ThreadLocal应该放入哈希表的下标
    int i = key.threadLocalHashCode & (len-1);

    //解决哈希碰撞 - 开发地址法(线性探测法)
    for (Entry e = tab[i];
         e != null;
         e = tab[i = nextIndex(i, len)]) {
        ThreadLocal<?> k = e.get();

        if (k == key) {
            e.value = value;
            return;
        }

        //解决内存泄漏
        if (k == null) {
            replaceStaleEntry(key, value, i);
            return;
        }
    }

    //将key和value封装成一个Entry对象,放入哈希表的指定位置
    tab[i] = new Entry(key, value);
    int sz = ++size;
    if (!cleanSomeSlots(i, sz) && sz >= threshold)
        rehash();
}
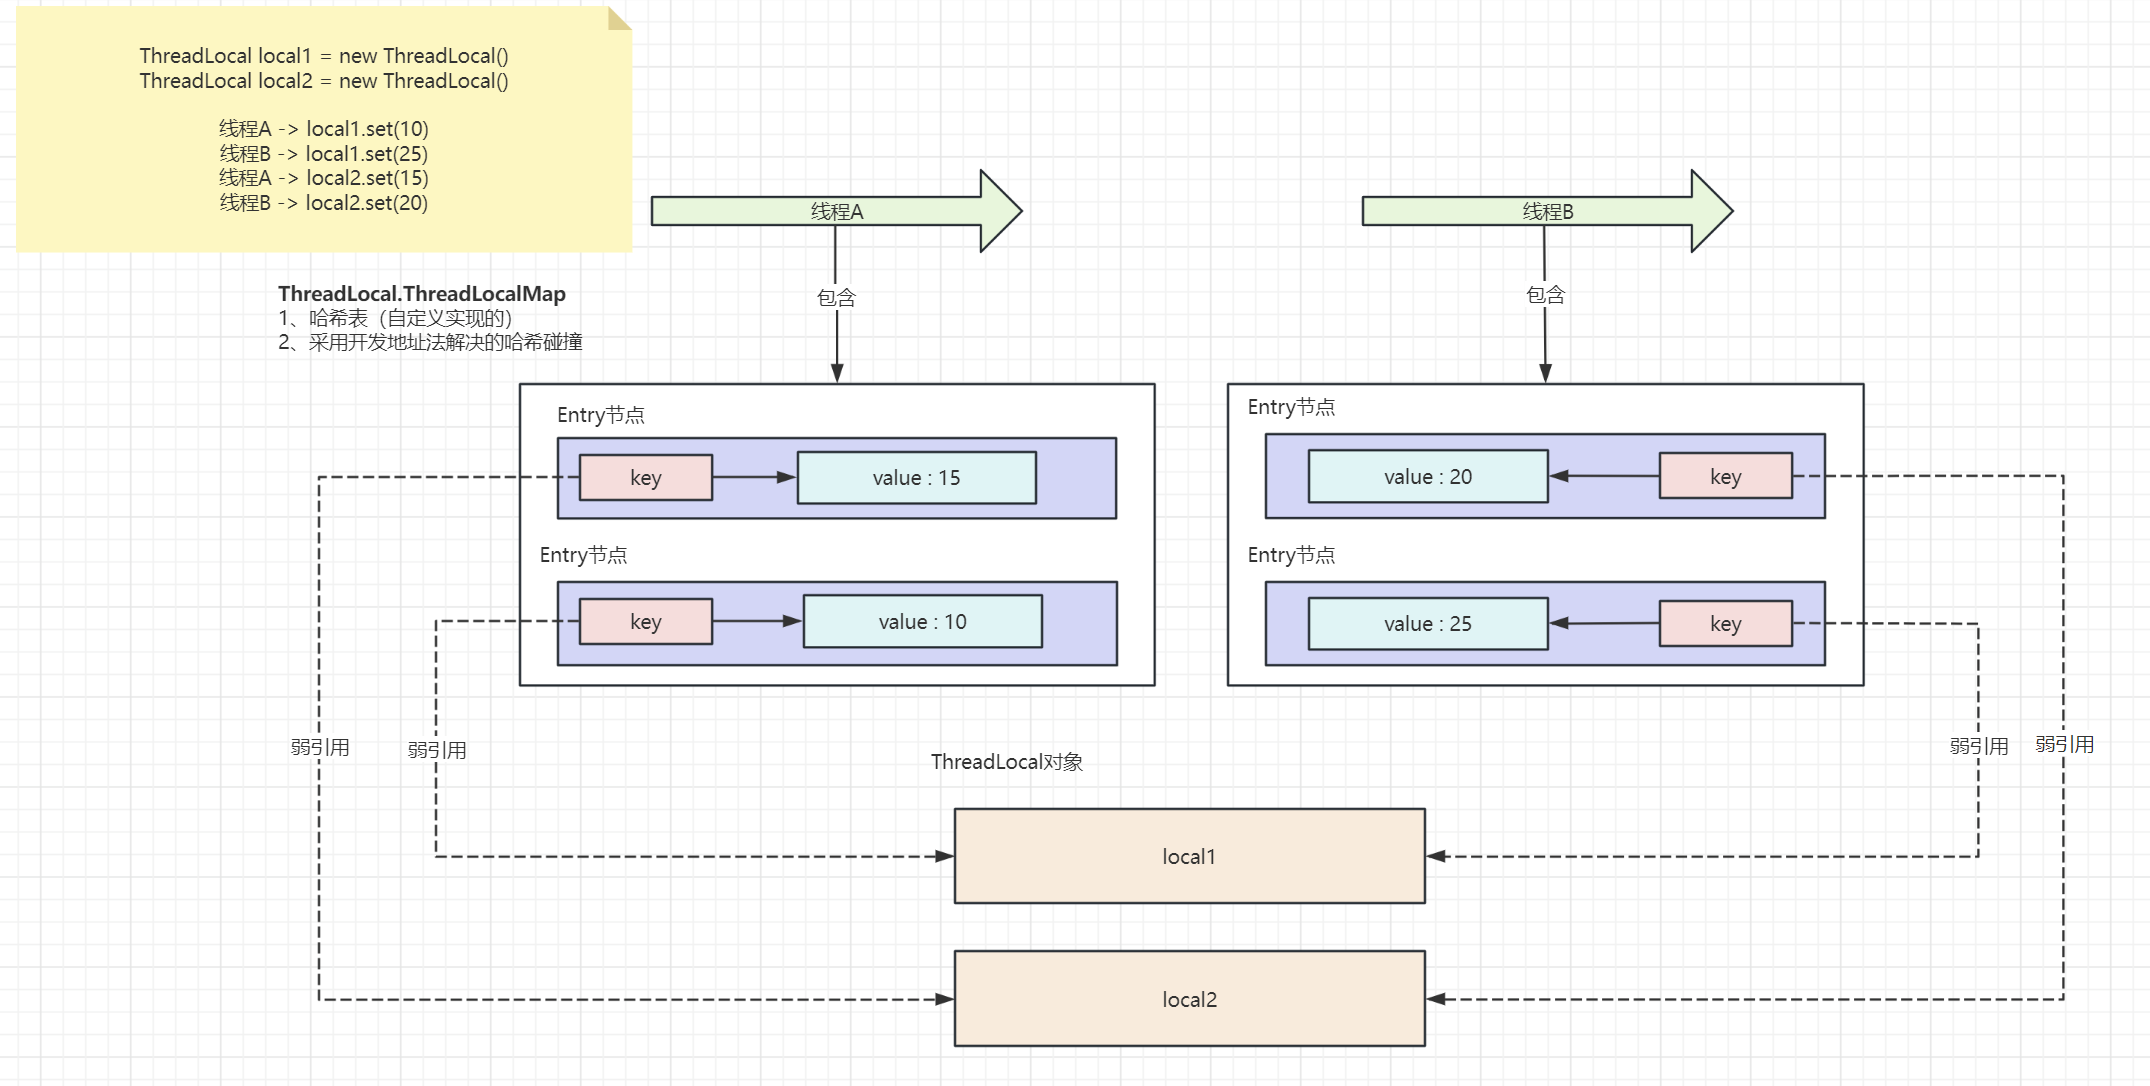
static class Entry extends WeakReference<ThreadLocal<?>> {
    Object value;

    Entry(ThreadLocal<?> k, Object v) {
        //ThreadLocalMap中的Entry节点是采用弱引用指向ThreadLocal的(考点)
        super(k);
        value = v;
    }
}

//等同于以下的代码
static class Entry {
	WeakReference<ThreadLocal> key;
    Object value;
    Entry(ThreadLocal<?> k, Object v) {
        key = new WeakReference(k);
        value = v;
    }
}
四大引用
- 强引用 - 项目中绝大部分的引用都是强引用,一个被强引用指向的对象,GC永远不会回收,宁可报OOM(内存溢出)
- **软引用 **- 内存足够时,GC不会回收软引用的资源,如果内存不足时,就会回收软引用指向的资源。软引用一般用于本地缓存的设计
- **弱引用 **- 弱引用指向的对象,只能活到下一次GC触发
- **虚引用 **- 跟踪引用对象被GC回收的过程,需要配合引用队列
为什么ThreadLocalMap需要采用弱引用指向ThreadLocal?
ThreadLocal防止内存泄漏的一种机制。当一个ThreadLocal使用完毕后,如果开发者没有正常的调用remove()方法,则当前ThreadLocal的强引用会自动的消失,如果ThreadLocalMap中的key还是使用强引用指向ThreadLocal的话,则当前ThreadLocal就不会被GC回收掉。直到Thread消亡(有可能是线程池中的线程),这就引发了内存泄漏。 ThreadLocalMap的弱引用机制,只能解决key的内存泄漏问题,但是不能解决Value的内存泄漏问题。但是ThreadLocalMap在设置元素时,会有value内存泄漏的弹出,从而释放掉内存泄漏的Value。但是这个过程是一个比较消耗性能的过程,因此实际开发过程中,每次用完ThreadLocal一定要调用remove方法
1.3.3 线程并发安全的三要素
什么是线程安全问题?
在多线程环境下,当有多个线程同时操作(增删改)同一份资源时,因为线程调度得到不确定性,导致的资源一致性问题,就称之为线程安全问题
线程安全问题三要素
- **可见性 - **当前线程对一个数据的修改,其他线程是立即可见的
- **原子性 - **一个线程执行过程,要么要没有开始,要么已经执行结束,没有中间状态
- **有序性 **
- **指令重排 - **CPU为了保证执行效率问题,在执行某些程序时,有可能不是按照编写顺序执行的,而是会打乱代码的执行顺序,这种现象称之为指令重排
- 指令重排的保证 - 重排后的程序执行结果对单线程来说不会造成影响
public static volatile boolean flag = true;

public static void main(String[] args) throws InterruptedException {
    new Thread(() -> {
        while(flag){}
        //最后这句话永远不会得到执行
        System.out.println("线程1的循环结束了......");
    }).start();

    Thread.sleep(500);

    new Thread(() -> {
        System.out.println("线程2要修改flag的值");
        flag = false;
        System.out.println("线程2修改完成:" + flag);
    }).start();
}
//解决方案:采用AtomicInteger 保证操作的原子性
public static volatile AtomicInteger i = new AtomicInteger(0);

public static void main(String[] args) throws InterruptedException {

    CountDownLatch countDownLatch = new CountDownLatch(1000);

    for (int j = 0; j < 1000; j++) {
        new Thread(() -> {
            i.getAndIncrement();
            //线程计数方法
            countDownLatch.countDown();
        }).start();
    }

    //如果countDown方法没有执行满1000次,await方法永远阻塞
    countDownLatch.await();

    //打印i有可能不是等于1000
    System.out.println(i.get());

}
public static volatile boolean flag = true;
public static volatile Object obj = null;

public static void main(String[] args) throws InterruptedException {

    new Thread(() -> {
        //线程1
        while (flag) {}
        //有可能导致空指针异常
        obj.hashCode();
    }).start();

    new Thread(() -> {
        //线程2
        obj = new Object();
        flag = false;
    }).start();
}
线程安全问题的解决方案 volatile关键字的作用
volatile有两层语义: 1、保证了不同线程对这个变量进行操作时的可见性,即一个线程修改了某个变量的值,这新值对其他线程来说是立即可见的; 2、禁止进行指令重排序;
特性
1)当一个变量被volatile修饰时,任何线程对它的写操作都会立即刷新到主内存中,并且会强制让缓存了该变量的线程中的数据清空,必须从主内存重新读取最新数据; 2)volatile修饰之后并不是让线程直接从主内存中获取数据,依然需要将变量拷贝到工作内存中;
内存屏障
volatile原理是基于CPU**内存屏障(Memory Barrier)**指令实现的,内存屏障会提供3个功能: 1)它确保指令重排序时不会把其后面的指令排到内存屏障之前的位置,也不会把前面的指令排到内存屏障的后面;即在执行到内存屏障这句指令时,在它前面的操作已经全部完成; 2)它会强制将对缓存的修改操作立即写入主存; 3)如果是写操作,它会导致其他CPU中对应的缓存行无效。
synchronized语义
- 内存可见性:同步块的可见性是由“如果对一个变量执行lock操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新从主存中加载变量的值”、“对一个变量执行unlock操作之前,必须先把此变量同步回主内存中”这两条规则获得的;
- 操作原子性:持有同一个锁的两个同步块只能串行地进入;
- 当线程释放锁时,JMM(Java内存模型)会把该线程对应的本地内存中的共享变量刷新到主内存中;
- 当线程获取锁时,JMM会把该线程对应的本地内存置为无效。从而使得被监视器保护的临界区代码必须从主内存中读取共享变量
其他的一些解决方案
- volatile
- synchronized
- Lock锁
- AtomicXxxxx类(所有方法具备原子性)
- CAS(乐观锁)
- 分布式锁(redis、zookeeper、数据库)
- 线程安全的类(ConcurrentHashMap、StringBuffer.....)
- redis + lua脚本
二、JavaWeb - 二阶段
2.1 MySQL相关面试题
2.1.1 谈谈MySQL优化(SQL优化)
根据我的经验,MySQL优化大致可以从几个纬度入手。 1)在数据库设计阶段,考虑好合理的表结构以及字段的类型,尽量选择合适并且占用空间更小的类型,减少数据读写时的内存和CPU使用占比。 2)在项目运行过程中,通过慢查询日志或者其他的一些工具(Druid、Skywalking),监控到运行较慢的SQL,针对这些SQL可以进行特定的优化(通过查看执行计划了解SQL的执行过程,结合optimizer_trace分析数据库优化器的优化策略,另外也可以根据show warnings查看优化器优化过后的sql结构,了解数据库真实执行的sql是什么样子的,再根据SQL的结构适当的添加设计索引,也可以调整SQL本身的结构,尽量减少SQL扫描的数据行数,在创建索引时,可以特意的使用上覆盖索引提升SQL的执行效率)。而且在连接查询是,可以通过调整连接的join算法,提升连接效率(比如 有时可以改变驱动表和被驱动表的顺序,或者通过8,0的hint语法,禁用索引,来强制使用hash join,某些情况下也可以获得很大的性能提升) 3)根据某些场景也可以适当的调整一些数据库的参数,比如(join_buffer/sort_buffer),这种方式更多还是DBA操作。 4)从锁优化的角度,把MySQL默认隔离级别设置为RC,提高读写的并发性。另外,也可以调整业务的复杂程度(大业务拆分成小业务),减少事务的范围,减少事务锁的持续时间。尽量使用行锁,不要显示的使用表锁。也可以在业务中使用本地锁或者分布式锁来解决数据一致性的问题,避免数据库连接被长时间锁定,浪费数据库的资源。 5)如果数据量过大,可能索引等优化手段并不能很好的解决数据库的性能问题了(几千万),这时就需要从库表结构入手(分库分表 + 读写分离) 6)有些时候更换服务器硬件也能带来很好的数据库的性能提升,采用多核CPU、更大的内存、固态硬盘.... 7)业务优化的角度,通过调整业务的方式,改变SQL的结构,从而达到提升效率的目的
- 通过调整业务,将一个大业务拆分成一些小业务,通过不同的请求,访问不同的业务,多次操作数据库获得结果
- 单线程操作转换成多线程批量操作(1千万 -> 100W * 10)
2.1.2 MySQL索引的底层原理以及查询流程
MySQL的底层索引采用的是B+Tree的数据结构来实现的。B+Tree本质上是一颗绝对平衡的多路树,所有的数据最终都会出现在叶子节点上,并且叶子节点之间采用的是双向链表连接,更方便于范围查询。再B+Tree中,每个节点都对应一个磁盘块,这样只需要使用一次的磁盘IO,就可以读取一个节点数据。因此B+Tree是一个专门用于磁盘搜索的数据结构,非常适合用来进行索引的实现。 MySQL是如何通过B+Tree搜索数据的? 首先分析器会分析执行的SQL,是否能使用当前索引,如果可以使用的话,则会通过索引检索。具体的搜索过程是,先在内存中,找到索引B+Tree的根节点(MySQL所有索引的根节点是常驻内存的)。将SQL的相关查询条件,导入节点中找到该条件的值对应的范围(这里采用的是二分查找法提高效率),通过根节点确定下一层节点的磁盘物理地址,进行一次磁盘IO获取下一个节点,再和下一个节点进行匹配(匹配方式相同),直到找到叶子节点中该条件值为止。如果使用的是主键索引(聚簇索引),这时叶子节点中就拥有完整数据行记录,直接返回即可。如果使用的是二级索引,叶子节点中的数据只包含id值,通过id再去主键索引进行一次搜索获取数据行记录。
2.1.3 什么是MVCC?有何作用?以及实现原理
MVCC 即多版本控制技术,主要的作用是为了提高MySQL数据库读写并发的性能。假如没有MVCC,当有多个事务对同一条数据进行并发读写时,为了保证数据的一致性(避免脏读等等问题),读写的两个事务必须加锁,串行执行。MVCC就可以避免这种情况,可以实现无锁化的并发读写的功能。 MVCC底层原理是基于两个隐式字段 + undo log + read view来实现的。大致的逻辑就是当一个查询的事务需要查询某张表时,会根据当前活跃的事务id结合undo log日志的数据版本链,生成一个适合于当前事务可以看到的数据快照,这个快照就是read view(读视图),在这个事务中,查询的SQL只会对这个快照进行查询,并不会去影响其他写入的事务(修改的原始数据)。基于这种机制,读和写之间就不是在操作同一个数据了,因此可以无锁化的并行执行。当然根据数据库隔离级别的不同,MVCC的实现细节也会不太一样,比如在RC模式下,同一个事务中,每次查询都会生成一次新的快照,对于RR模式下,一个事务中,多次查询只会使用同一快照(避免不可重复度) 快照读 - select .... (最普通的查询语句就是快照读,因此这种语句在底层是会生成read view) 当前读 - select ....for update (锁行,直接读取原始数据,不会生成read view)
2.1.4 MySQL中undo log、redo log和bin log分别有什么用?、
undo log - 回滚日志,在MySQL中,修改数据前,会将旧的数据写入到undo log中。这里有两个作用,第一是为了方便后续回滚,第二是为了生成一个数据的版本链,方便MVCC生成快照 redo log - 重做日志,主要是记录修改后的数据,当MySQL宕机,而最新的数据又没有及时刷盘的话,可以从redo log中找到曾经修改后的数据,进行回复 bin log - 归档日志(二进制日志),主要也是记录MySQL中所有数据的变化情况(具体记录什么,取决于bin log的记录格式),主要作用可以起到一个数据恢复的目的,当有某些误操作发生时,可以通过bin log日志,找到曾经的操作,进行回放,找回丢失数据等等。而且MySQL主从复制,也是依赖于bin log日志,主库将bin log日志发送给从库,从库的IO线程将其中的变化数据记录到中继日志中,另一个SQL线程读取中继日志,进行数据回放,从而达到主从复制的效果
2.1.5 MySQL主从复制的过程,以及如何解决MySQL主从延迟的问题
主从复制的过程:三线程,两文件 主库:log dump线程,bin log日志文件 从库:io线程、sql线程、中继日志 主从延迟的问题 在实际开发过程中,我们数据库的版本用的是MySQL8.0以上。根据MySQL主从复制的原理,大概可以看成两步,从库会从主库中实时获取binlog日志,记录到自己的中继日志中。从库还有一个SQL线程,从中继日志中获取数据回放,在从库中进行数据更新,以此达到主从数据一致的效果。从这个原理来看,首先,从库从主库的binlog日志中读取数据保存到中继的日志的过程,我们会采用半同步复制的方式,保证一致性,简答来说,就是主库会等待从库已经写入中继日志之后,才commit事务,因为这个特性,在这个过程中是不会发生延迟的。一般主从延迟的原因,大概率是发生在从库SQL线程回放的这个过程中,因为MySQL5.7之前,这个回放是单线程同步回放的,而主库是多线程并发写入(写入不同行),因此,在高并发场景下,从库回放的速度,往往赶不上主库写入的速度,就发生了所谓的同步延迟的问题。但是5.7之后,MySQL提供了基于组的并行回放,已经极大的解决了这个问题,所以在实际开发过程中,绝大部分的项目,如果采用了5.7以上的版本,几乎是不会发生主从延迟的。但是对于刚写入就立刻查询的场景,仍然是有可能存在一定的延迟,这时可以采用
- 强制读主
- 读取缓存方式的方式
来解决延迟问题。
5.7的优化(主从ack多线程、binlog日志的文件锁移除.....)
2.1.6 工作中如何实现分库分表?
有过分库分表的经验,比如在xxx项目中,xxx业务(订单、红包)当时就是用分库分表解决的。本身来说xxx数据日增长量比较大,达到十几万到几十万的级别,因此数据库中进行了分库分表。当时用了6个库每个库10张表的方式进行的拆分,代码层面使用的ShardingJDBC做的代理层,实现的分库分表的逻辑。具体的分库分表规则,我们当时是通过用户来进行划分,简单来说,就是根据用户id的个位数对库的数量取模,确定数据放入库的位置,在通过用户id的十位数对表的数量取模,确定数据放入表的位置。查询的时候为了保证查询的效率,直接去某个库某个表中查询,每次查询必须带上路由键,分配规则的字段,也是用户id。 但是有些场景,通过红包id(订单id),查询当前的数据信息,这时就可能会进行跨库跨表的操作。当时我们的解决方案,就是再建立一张 红包id和用户id关联的一张中间表,这个表的数据量也很大,因此也会分库分表,但是分库分表的规则,是根据红包id来确定的。因此只需要通过红包id 去映射表中找到用户id,再通过用户id确定库和表,就可以去某个表中直接找到当前的红包数据。当然,为了保证性能,在redis中,我们也会去缓存红包id 和 用户id的映射信息,只会缓存最近几天内的,因为红包抢完了之后,基本上就不会再用通过id查询红包信息的场景了。 另外,我们给每个分库,配置了一个slave,来实现读写分离,也就是红包库的整体架构,是按照用户id分库分表,同时,每个分库也实现了读写分离
三、框架微服务 - 三/四阶段
3.1 Spring框架相关面试题
3.1.1 什么是IOC?有什么作用?
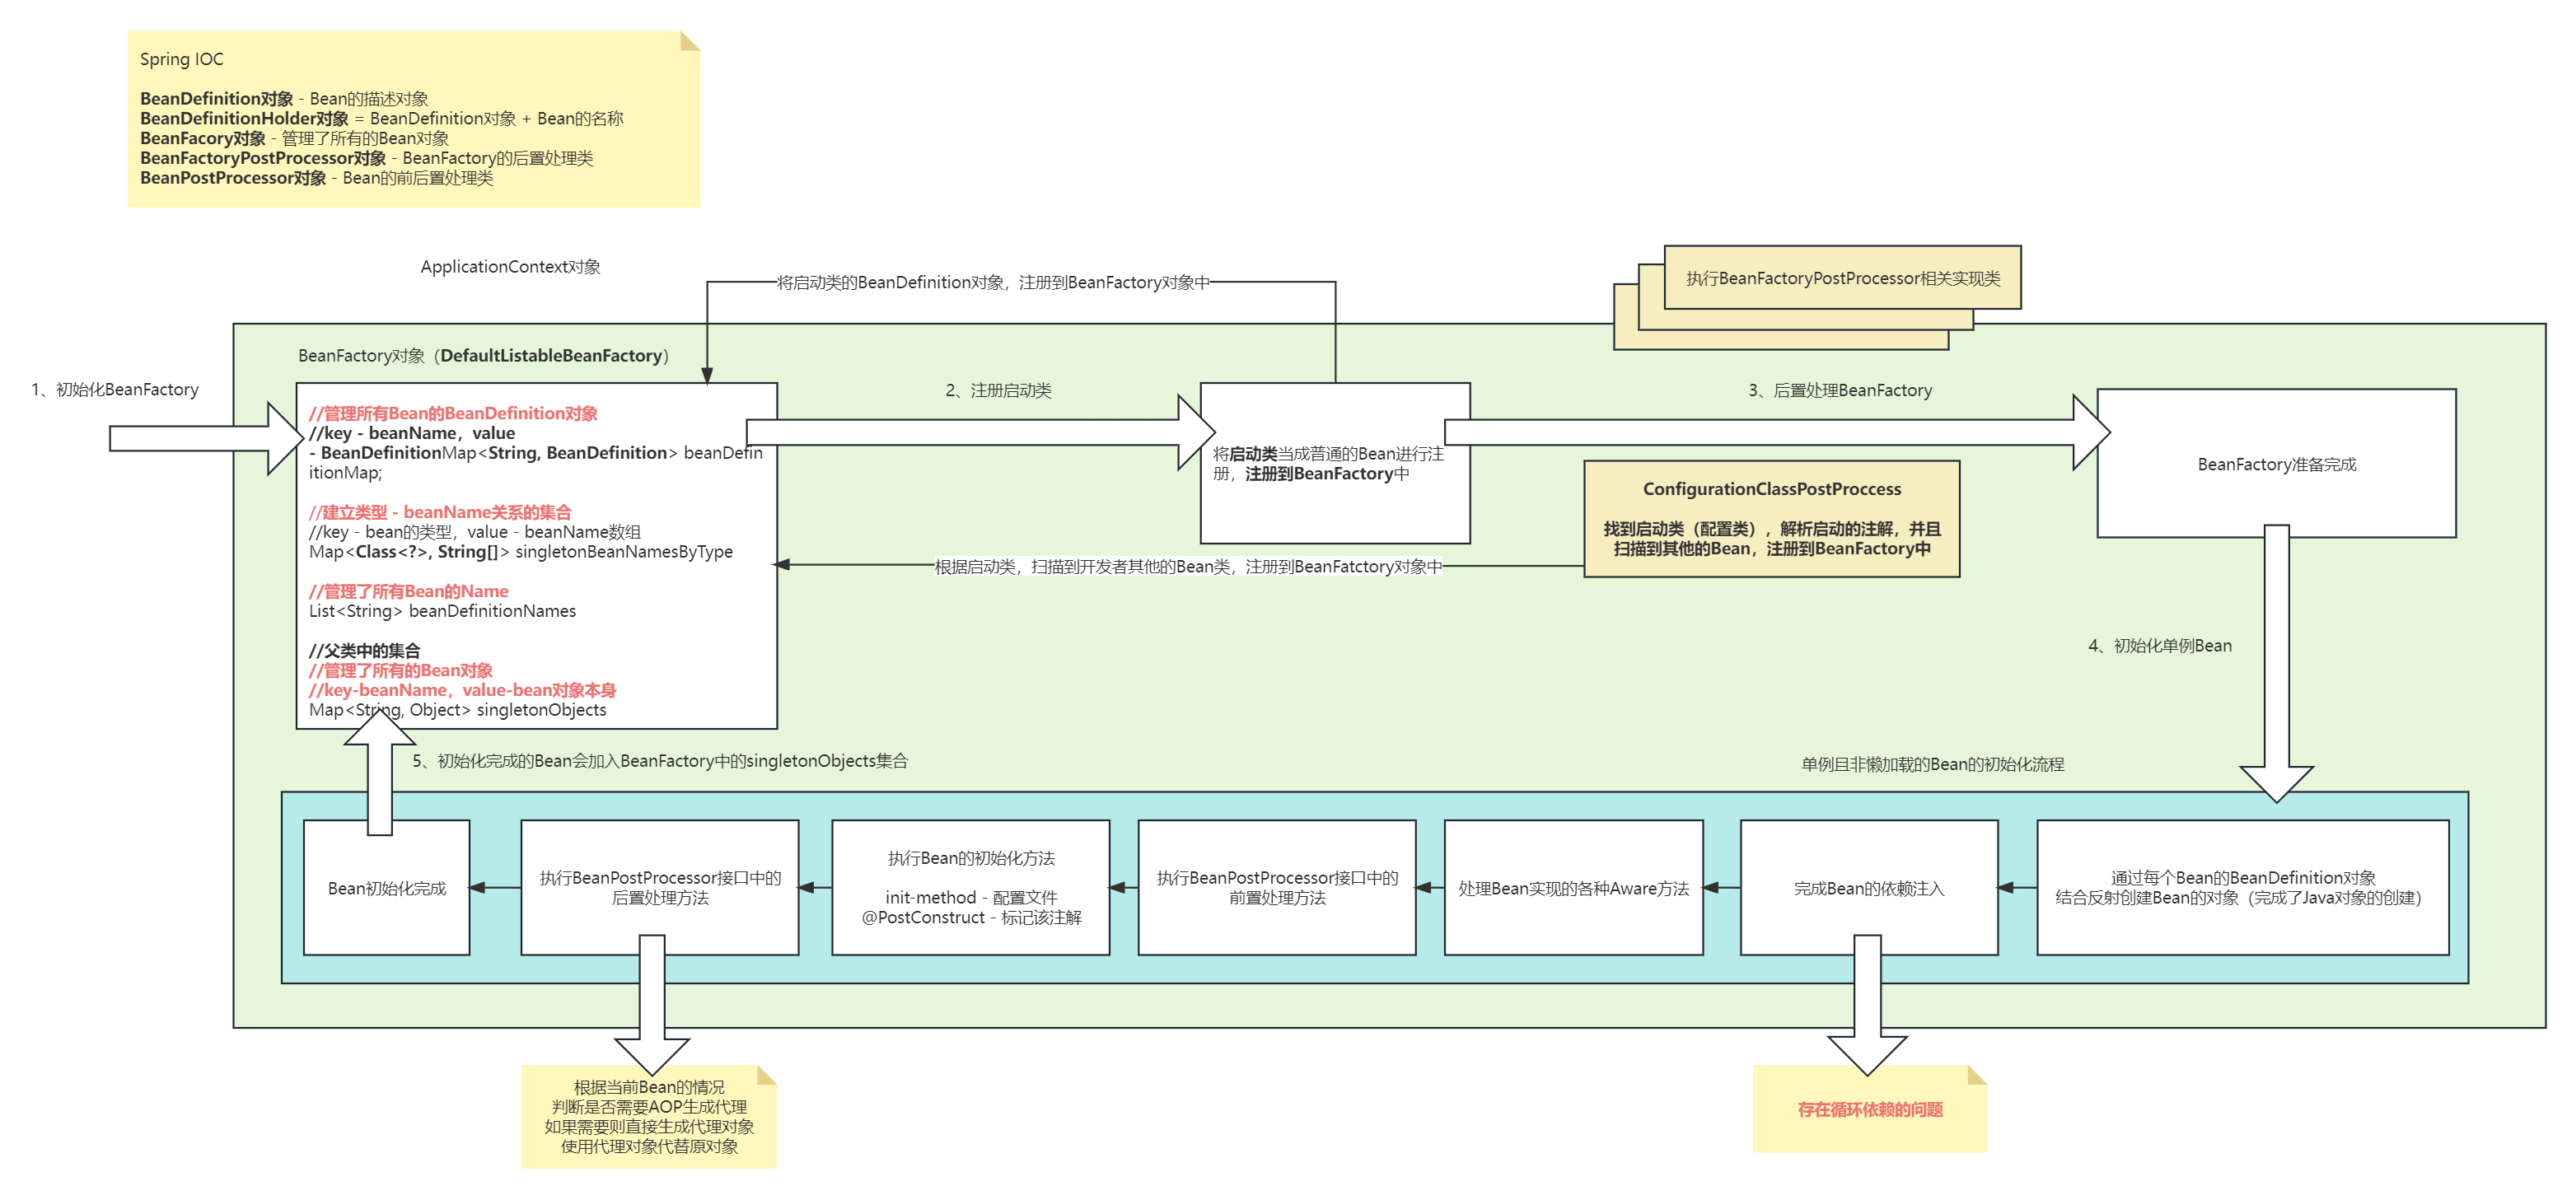
IOC - 控制反转,就是将对象创建的权利交给第三方管理(IOC容器),主要是为了解决对象与对象之间耦合度高的问题(解耦)。如果在一个A类中,直接new一个B类的对象,我们就称之为A类和B类发生了硬编码耦合。当B类的构造形式需要发生变化时,这时必须要修改A类,如果有很多类都硬编码了B类,那么这些类都需要进行修改,这就是硬编码缺陷的体现。而使用了IOC,A类和B类不会发生直接的关联,A类是被动的从IOC容器中获取B类的对象,B的构造形式发生任何变化时,都不需要去修改A类,这种就是解耦的体现。 构造形式发生变化的场景:
- 构造器变化(少见)
- 实现类的变化
- 需要进行代理(重点)
3.1.2 什么是AOP?谈谈实现原理以及运用场景
AOP - 面向切面编程,在实际开发过程中,一个业务可以分为核心业务与非核心业务,每个业务之间,核心业务都不相同,非核心业务往往确有相同的部分(开启事务、提交事务、回收资源、记录日志....),将非核心业务抽取出来形成一个个的切面,当运行正常业务时,再将这些切面织入到核心业务的前后,最终形成完整业务的这种编程方式,就称之为面向切面编程。 优势:开发者只需要关注核心业务即可,非核心业务在架构层面就已经实现了 底层实现:动态代理
- JDK动态代理
- 特点:必须基于接口,效率要高于CGlib,SpringBoot2.x之前的版本,默认选择该方式
- CGlib动态代理
- 特点:基于继承,目标类不能final修饰,SpringBoot2.x之后的版本,默认选择该模式
3.1.3 Spring是如何解决循环依赖的?
所谓的循环依赖就是指,A类中注入了B类的对象,B类中注入了A类的对象(互相注入)。形成循环依赖的形式有两种:
- 基于构造方法的循环注入 - 无解,会报错
- 基于@Autowrite的循环注入 - 基于三级缓存解决的循环注入问题
为什么构造方法循环注入无解?
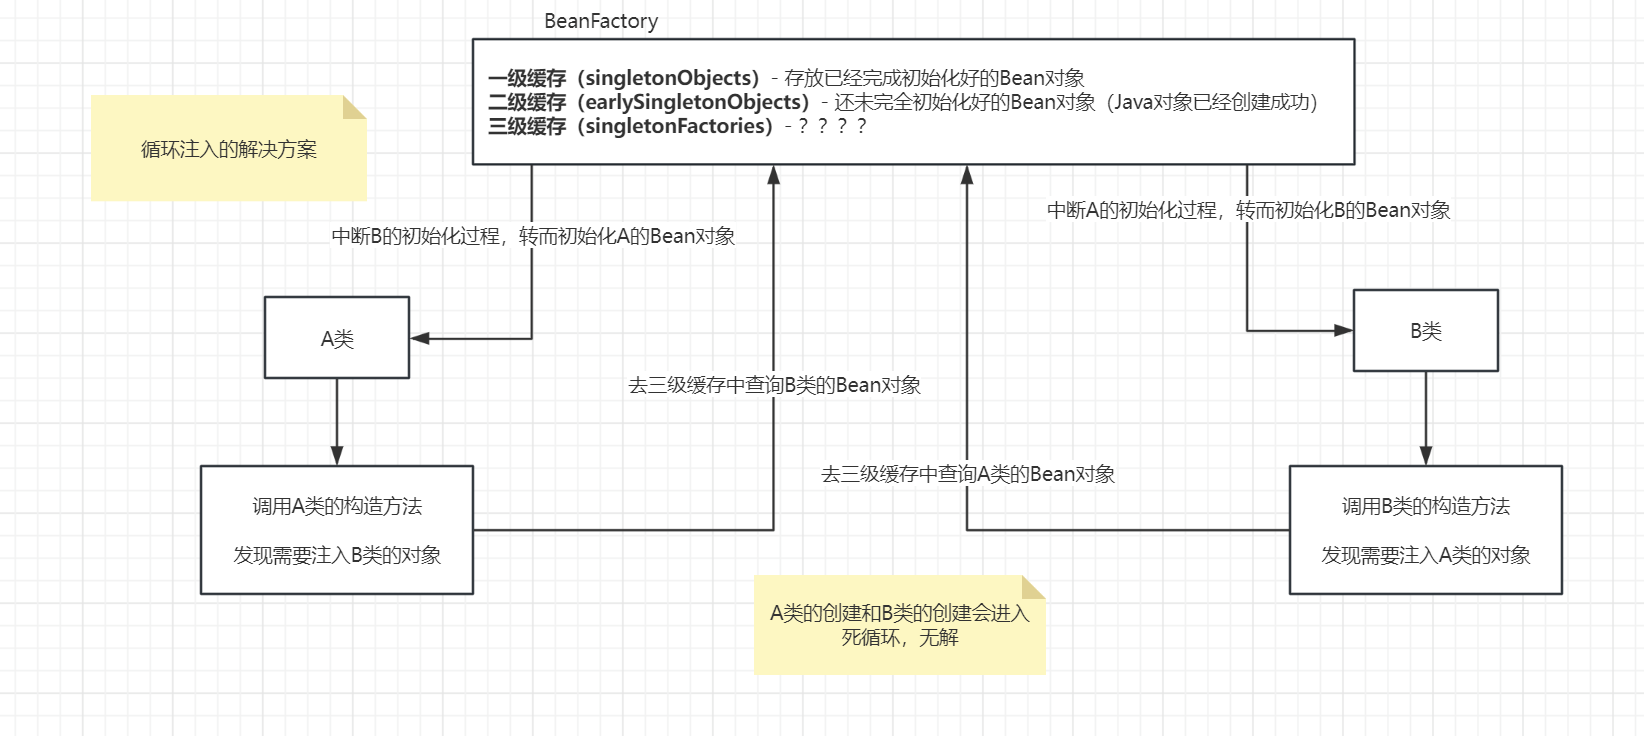 基于@Autowrite的循环注入如何解决的循环依赖
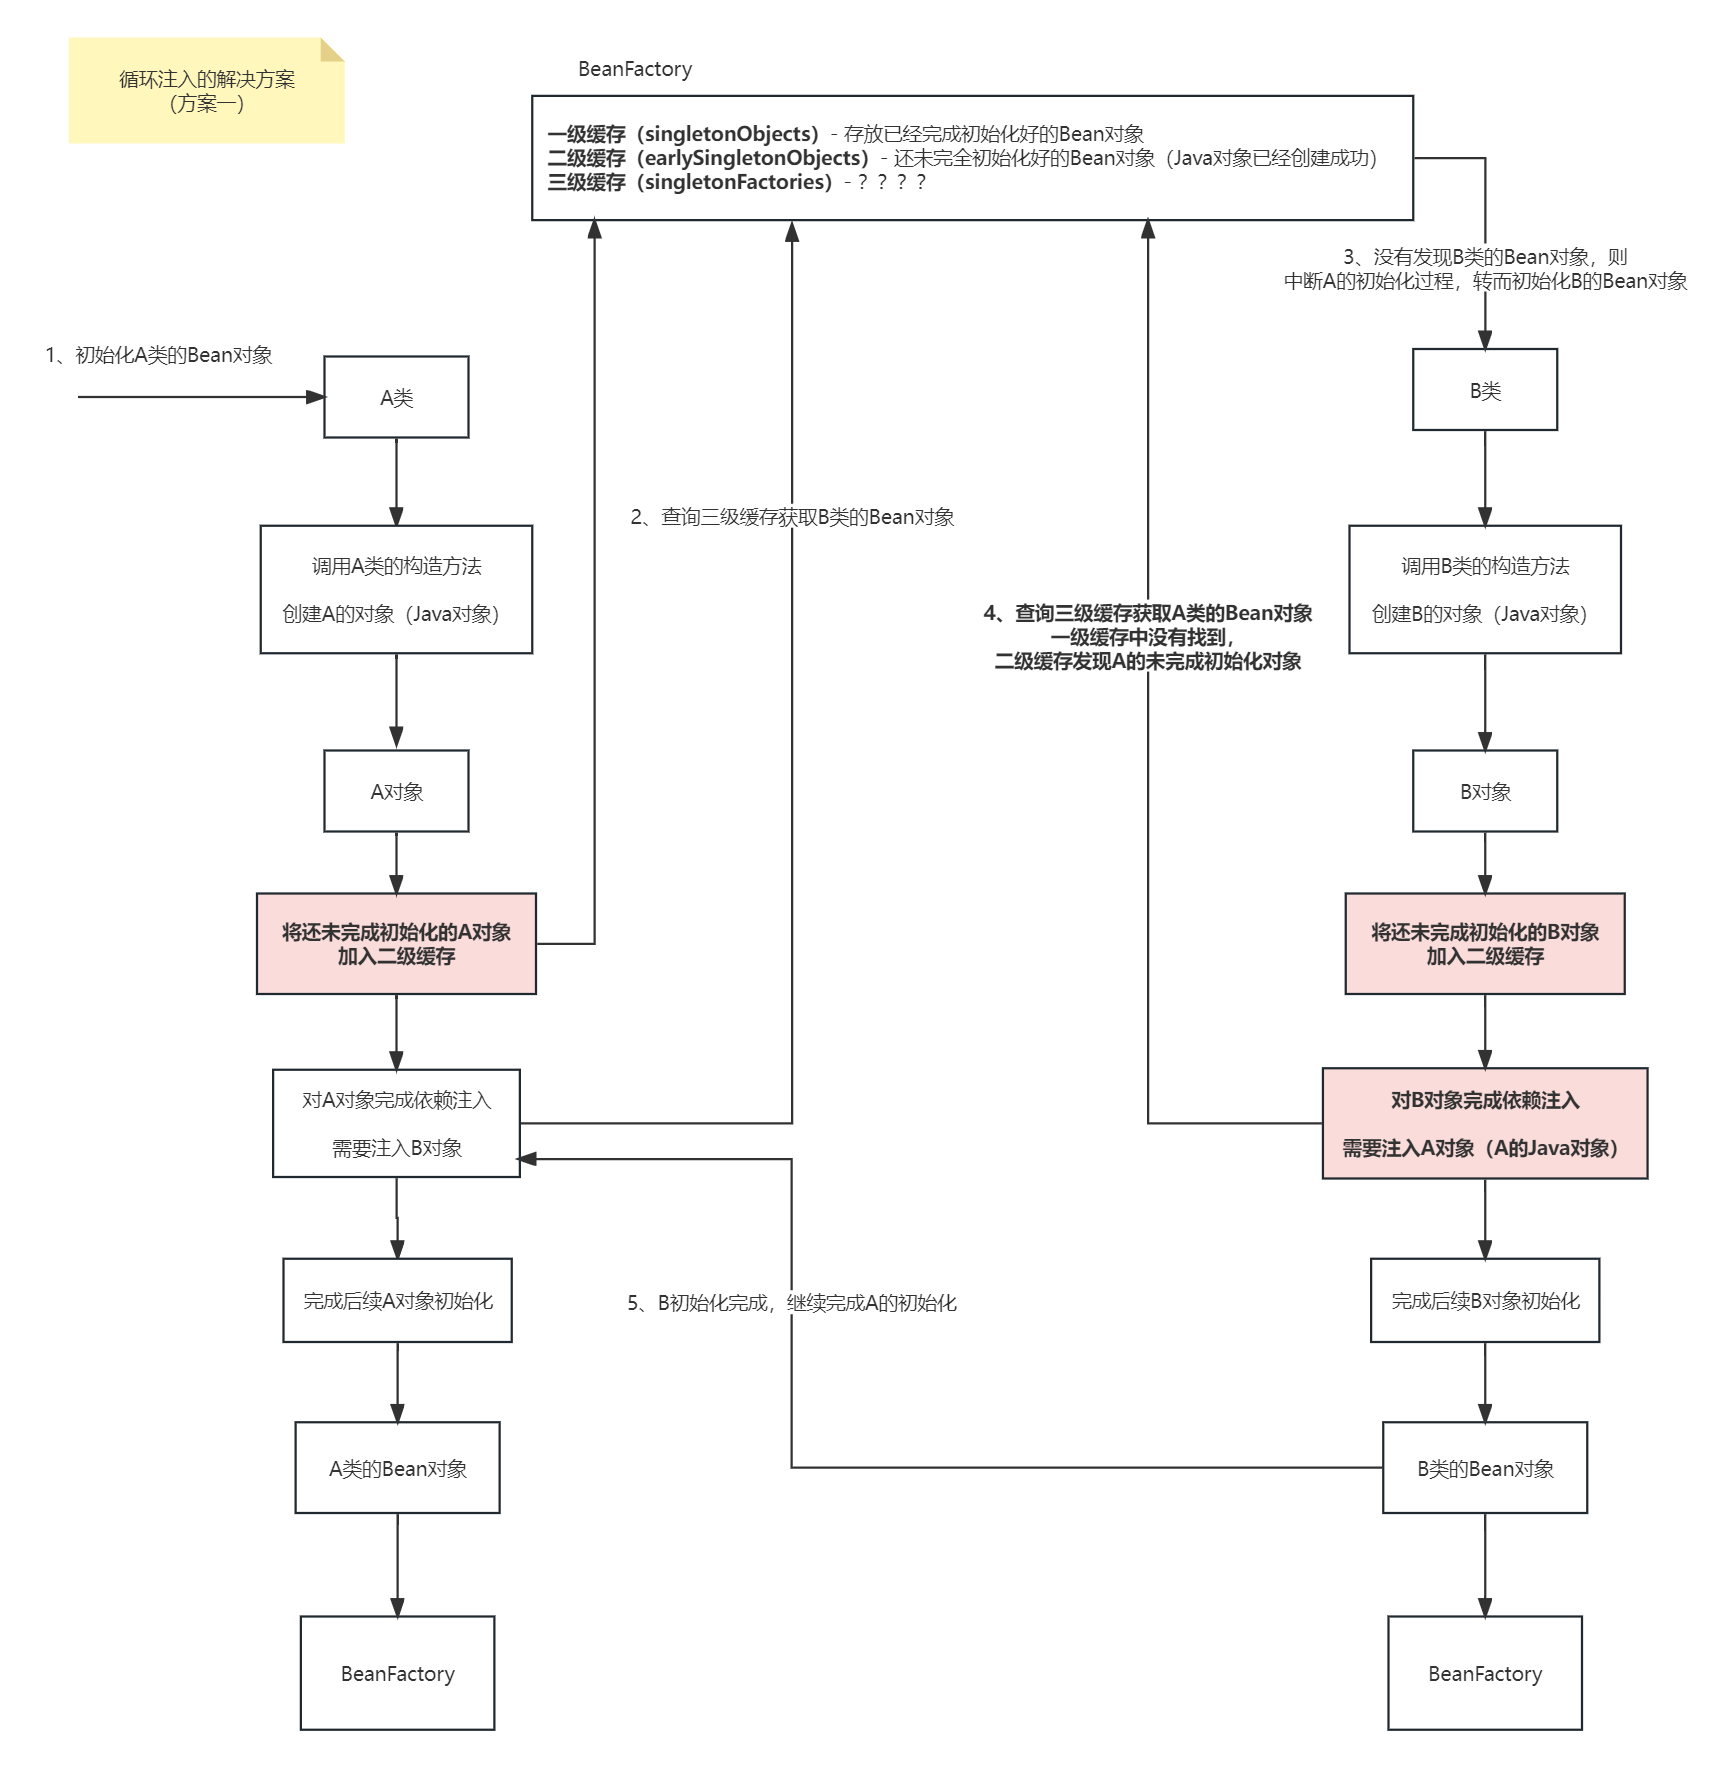 完成可以通过二级缓存解决循环依赖的问题,为何Spring设计了三级缓存?
为了解决动态代理问题
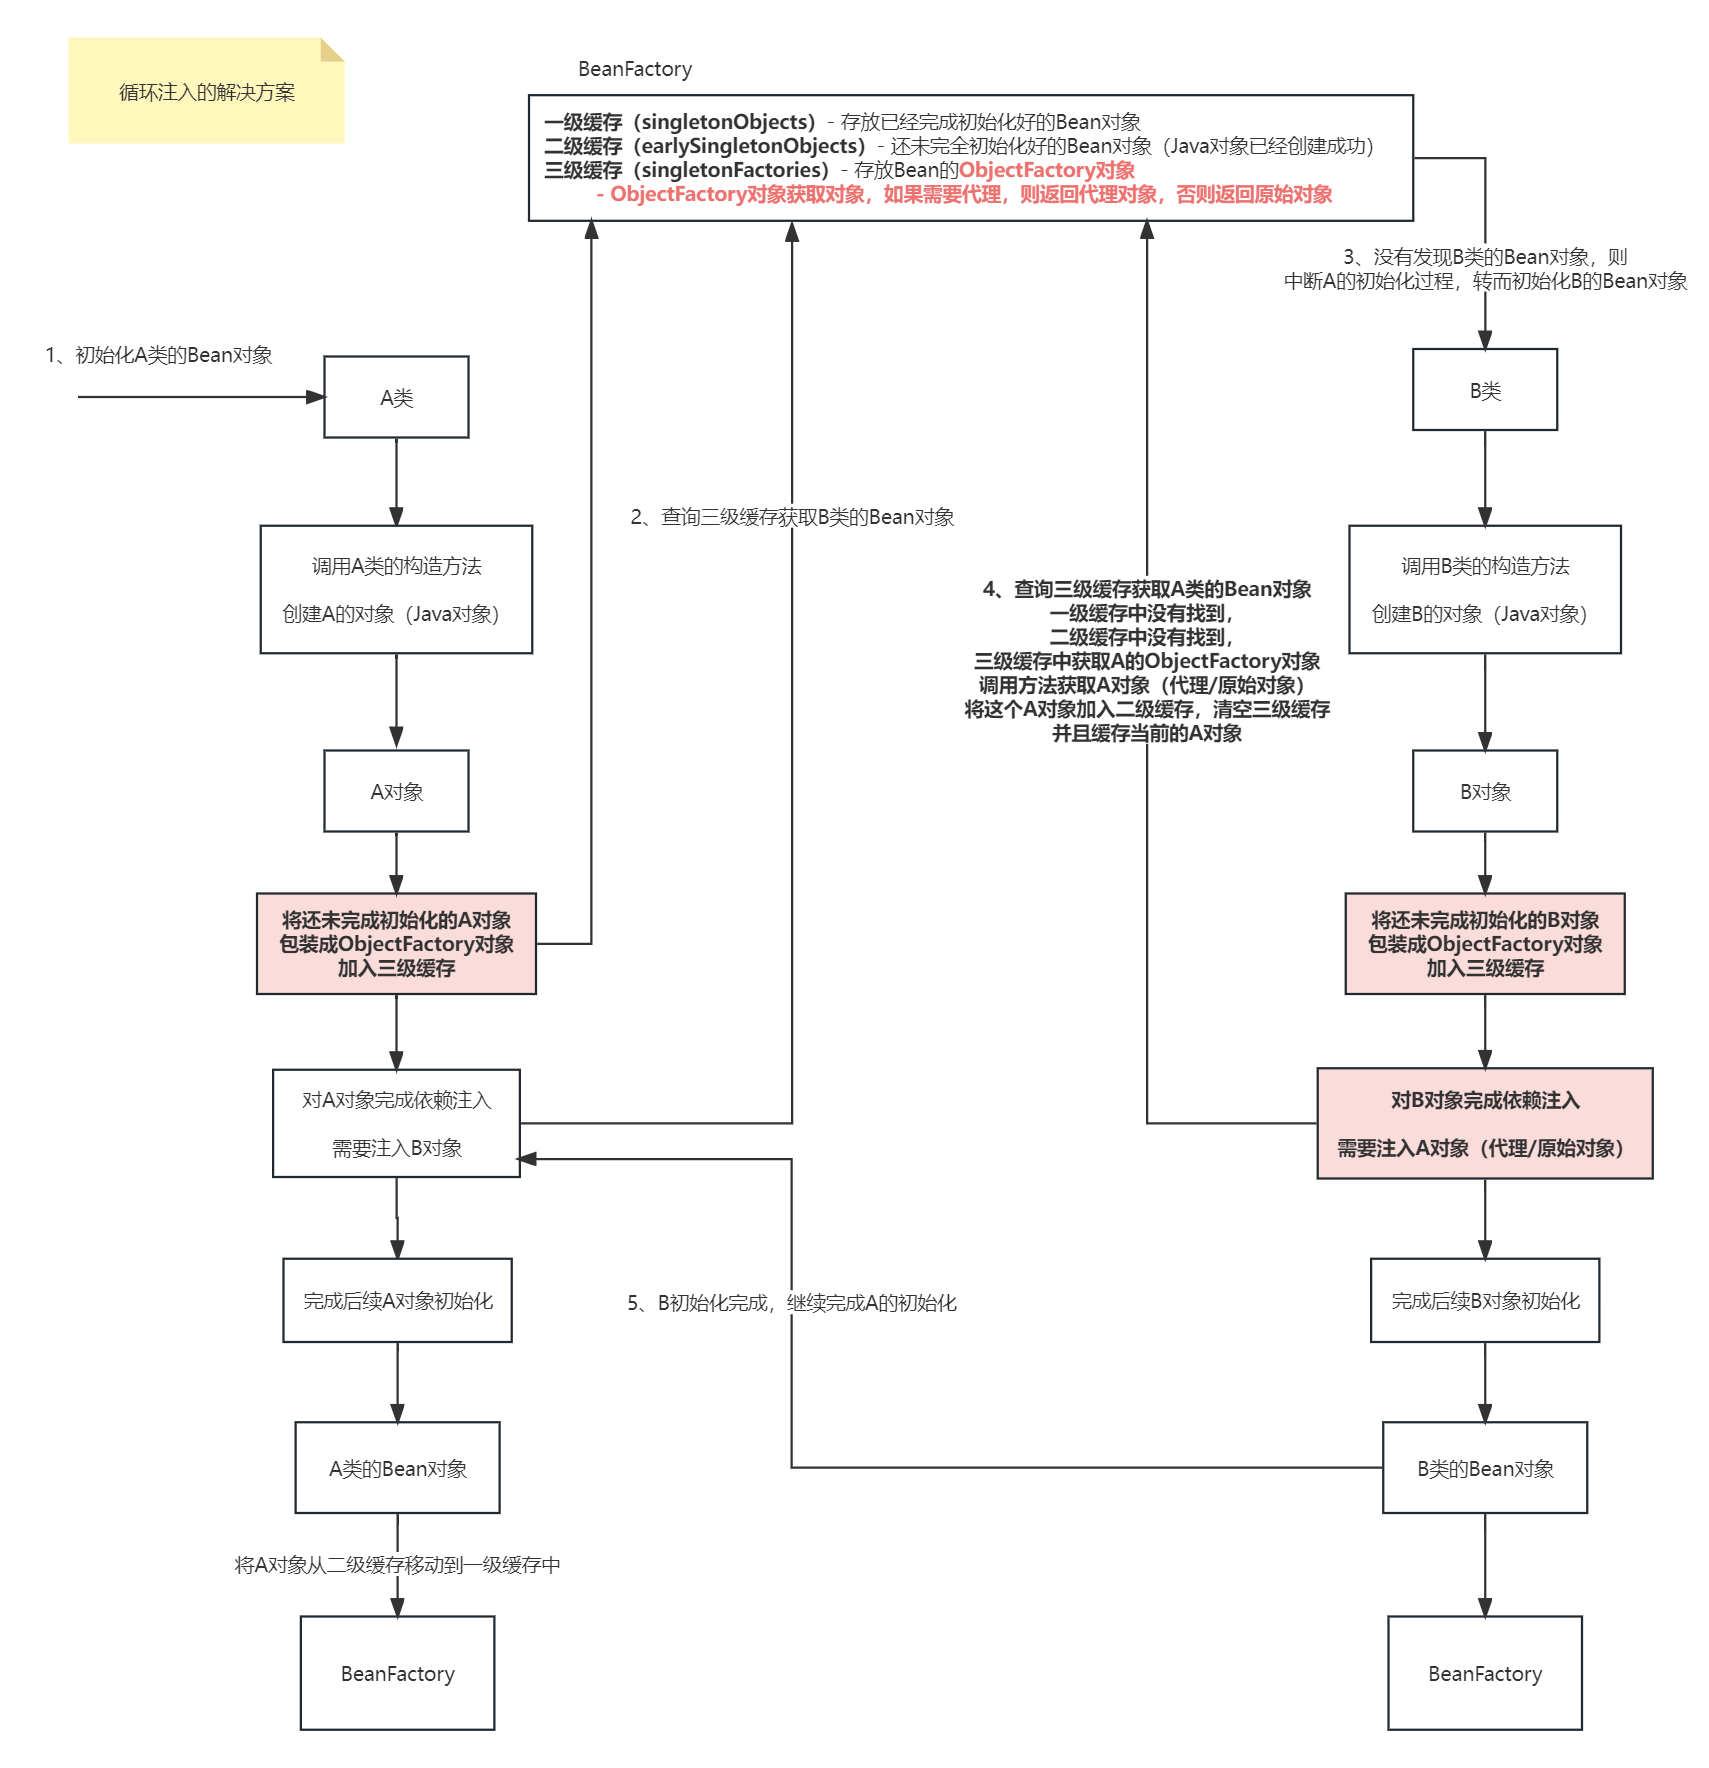
@Nullable
protected Object getSingleton(String beanName, boolean allowEarlyReference) {
	//从一级缓存中获取指定的Bean对象(完成初始化好的Bean对象)
    Object singletonObject = this.singletonObjects.get(beanName);
    if (singletonObject == null && isSingletonCurrentlyInCreation(beanName)) {
        //从二级缓存中获取Bean对象(未初始化完成的Bean对象)
        singletonObject = this.earlySingletonObjects.get(beanName);
        //如果二级缓存没有找到
        if (singletonObject == null && allowEarlyReference) {
            //保证多线程安全,对一级缓存对象加锁
            synchronized (this.singletonObjects) {
                //双重锁判定的设计
                singletonObject = this.singletonObjects.get(beanName);
                if (singletonObject == null) {
                    singletonObject = this.earlySingletonObjects.get(beanName);
                    if (singletonObject == null) {
                        //一级缓存和二级缓存还是没有指定的Bean对象
                        //从三级缓存中获取指定Bean对象的包装对象ObjectFactory
                        ObjectFactory<?> singletonFactory = this.singletonFactories.get(beanName);
                        if (singletonFactory != null) {
                            //获取指定的Bean对象(代理/原始)
                            singletonObject = singletonFactory.getObject();
                            //将结果放入二级缓存
                            this.earlySingletonObjects.put(beanName, singletonObject);
                            //移除三级缓存
                            this.singletonFactories.remove(beanName);
                        }
                    }
                }
            }
        }
    }
    return singletonObject;
}
所谓的循环依赖,就是指Spring中,Bean对象的互相注入问题。如果是通过构造方法循环注入,这个问题无解,Spring默认会报错。如果是通过属性注入,则Spring是基于三级缓存的方式解决的循环依赖。第一级缓存中,存放的是已经完成初始化了的Bean,第二级缓存中存放是还未完全初始化好的Bean(半成品,只是初始化完成的Java对象),第三级缓存是Bean对象的一个包装对象ObjectFactory,该对象可以返回Bean原始对象或者代理对象。如果发生循环依赖,则第一个Bean会包装成ObjectFactory对象先放入第三级缓存,然后暂停初始化,进行第二个Bean的初始化,当第二个Bean需要注入第一个Bean时,会从第三级缓存中获取该Bean的半成品对象,并且放入二级缓存,继续完成第二个Bean的后续初始化。再继续进行第一个Bean的初始化过程。这样就解决了循环依赖的问题。 第三级缓存的设计,主要是为了解决AOP代理的问题。 官方不太推荐循环依赖的做法,如果需要进行循环依赖,可以创建一个中间层,将双方依赖共同注入进去。
3.1.4 什么是Spring的事务传播行为?
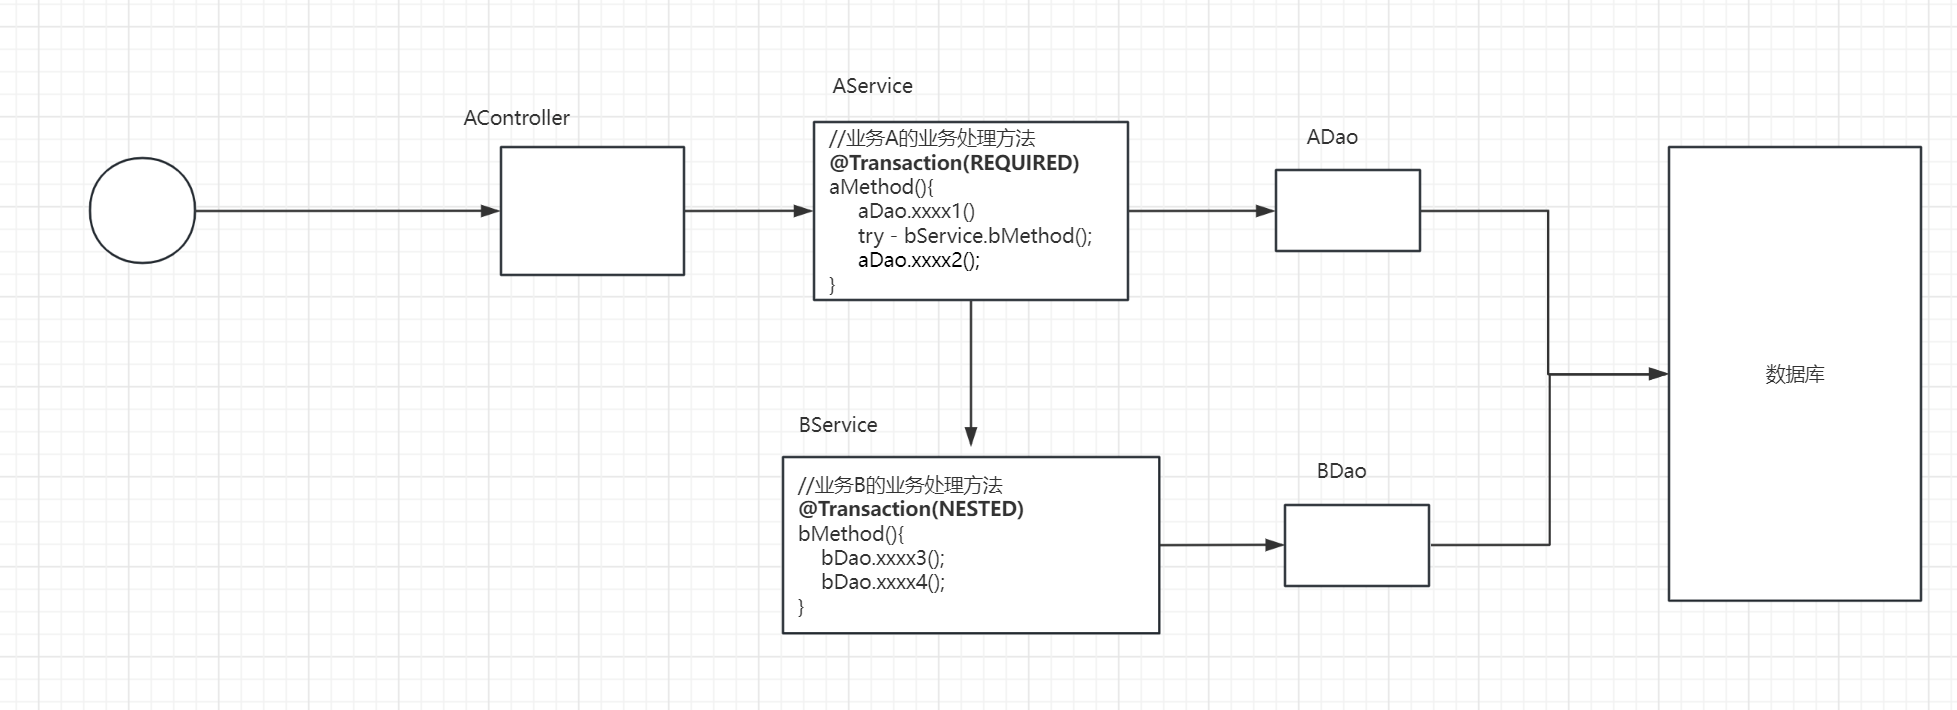
Spring的事务传播行为主要是为了解决,实际开发过程中,业务之间互相调用时,事务的管理范围问题
指定事务的传播行为
@Transactional(propagation = Propagation.REQUIRED)
| 传播行为 | 解释 |
|---|---|
| REQUIRED(默认行为) | 当方法调用时,如果不存在当前事务,则创建新的事务,如果之前的方法存在事务,就沿用之前的事务 |
| SUPPORTS | 当前方法调用时,如果不存在事务则不启用事务,如果存在事务就沿用当前事务 |
| MANDATORY | 方法必须运行在事务中,如果不存在事务,则抛出异常 |
| REQUIRES_NEW | 方法每次都会开启新的事务 |
| NOT_SUPPORTED | 不支持事务,如果当前存在事务,则会将当前事务挂起,直到该方法结束才会恢复事务 |
| NEVER | 不支持事务,如果存在事务则抛出异常 |
| NESTED | 嵌套事务,如果方法抛出异常只回滚自己内部的sql |
3.1.5 FactoryBean和BeanFacory有什么区别?
BeanFacory - 是Spring用来创建并且存放所有Bean的容器的统一接口 FactoryBean - 是Spring用来创建一些复杂对象的工厂接口,现在完成可以通过**@Bean注解**来代替
3.1.6 简述Spring事务失效的场景
1、错误的使用了事务传播行为时,可能导致事务失效 2、开发者手动在业务方法内部捕获了异常(开发者需要在捕获异常后,再次手动抛出即可) 3、在默认情况下@Transaction注解只会对运行时异常进行回滚,当业务抛出非运行异常时,事务会失效 4、抛出的异常不匹配@Transaction注解中的rollbackFor指定的异常 5、在一个业务类中,业务方法之间进行了互调,被调用的方法因为不是通过代理层调用,所以事务会失效
- 业务层中注入自己的Bean对象,然后在方法互调时,通过注入的Bean对象调用,让代理层生效
- 手动获取当前类的代理层对象
- @EnableAspectJAutoProxy(exposeProxy = true)
- ((强转)(AopContext.currentProxy()))
3.2 Kafka相关面试题
3.2.1 如何保证消息的有序性

对于Kafka来说,想要保证消息的有序性,只需要做到几点即可:
- 有序消息一定来自于一个生产者
- 有序消息必须发送给同一个主题
- 有序消息需要发往同一个主题的同一个分区(要么直接指定分区号,要么指定同一个key)
- 对于同一个消费者组的消费者来说,接收的消息就是有序的,但是如果要保证消费有序,还需要保证消费者消费消息时,不能使用多线程,或者保证这些有序消息是被同一个线程消费的
3.2.2 如何确保消息的可靠性
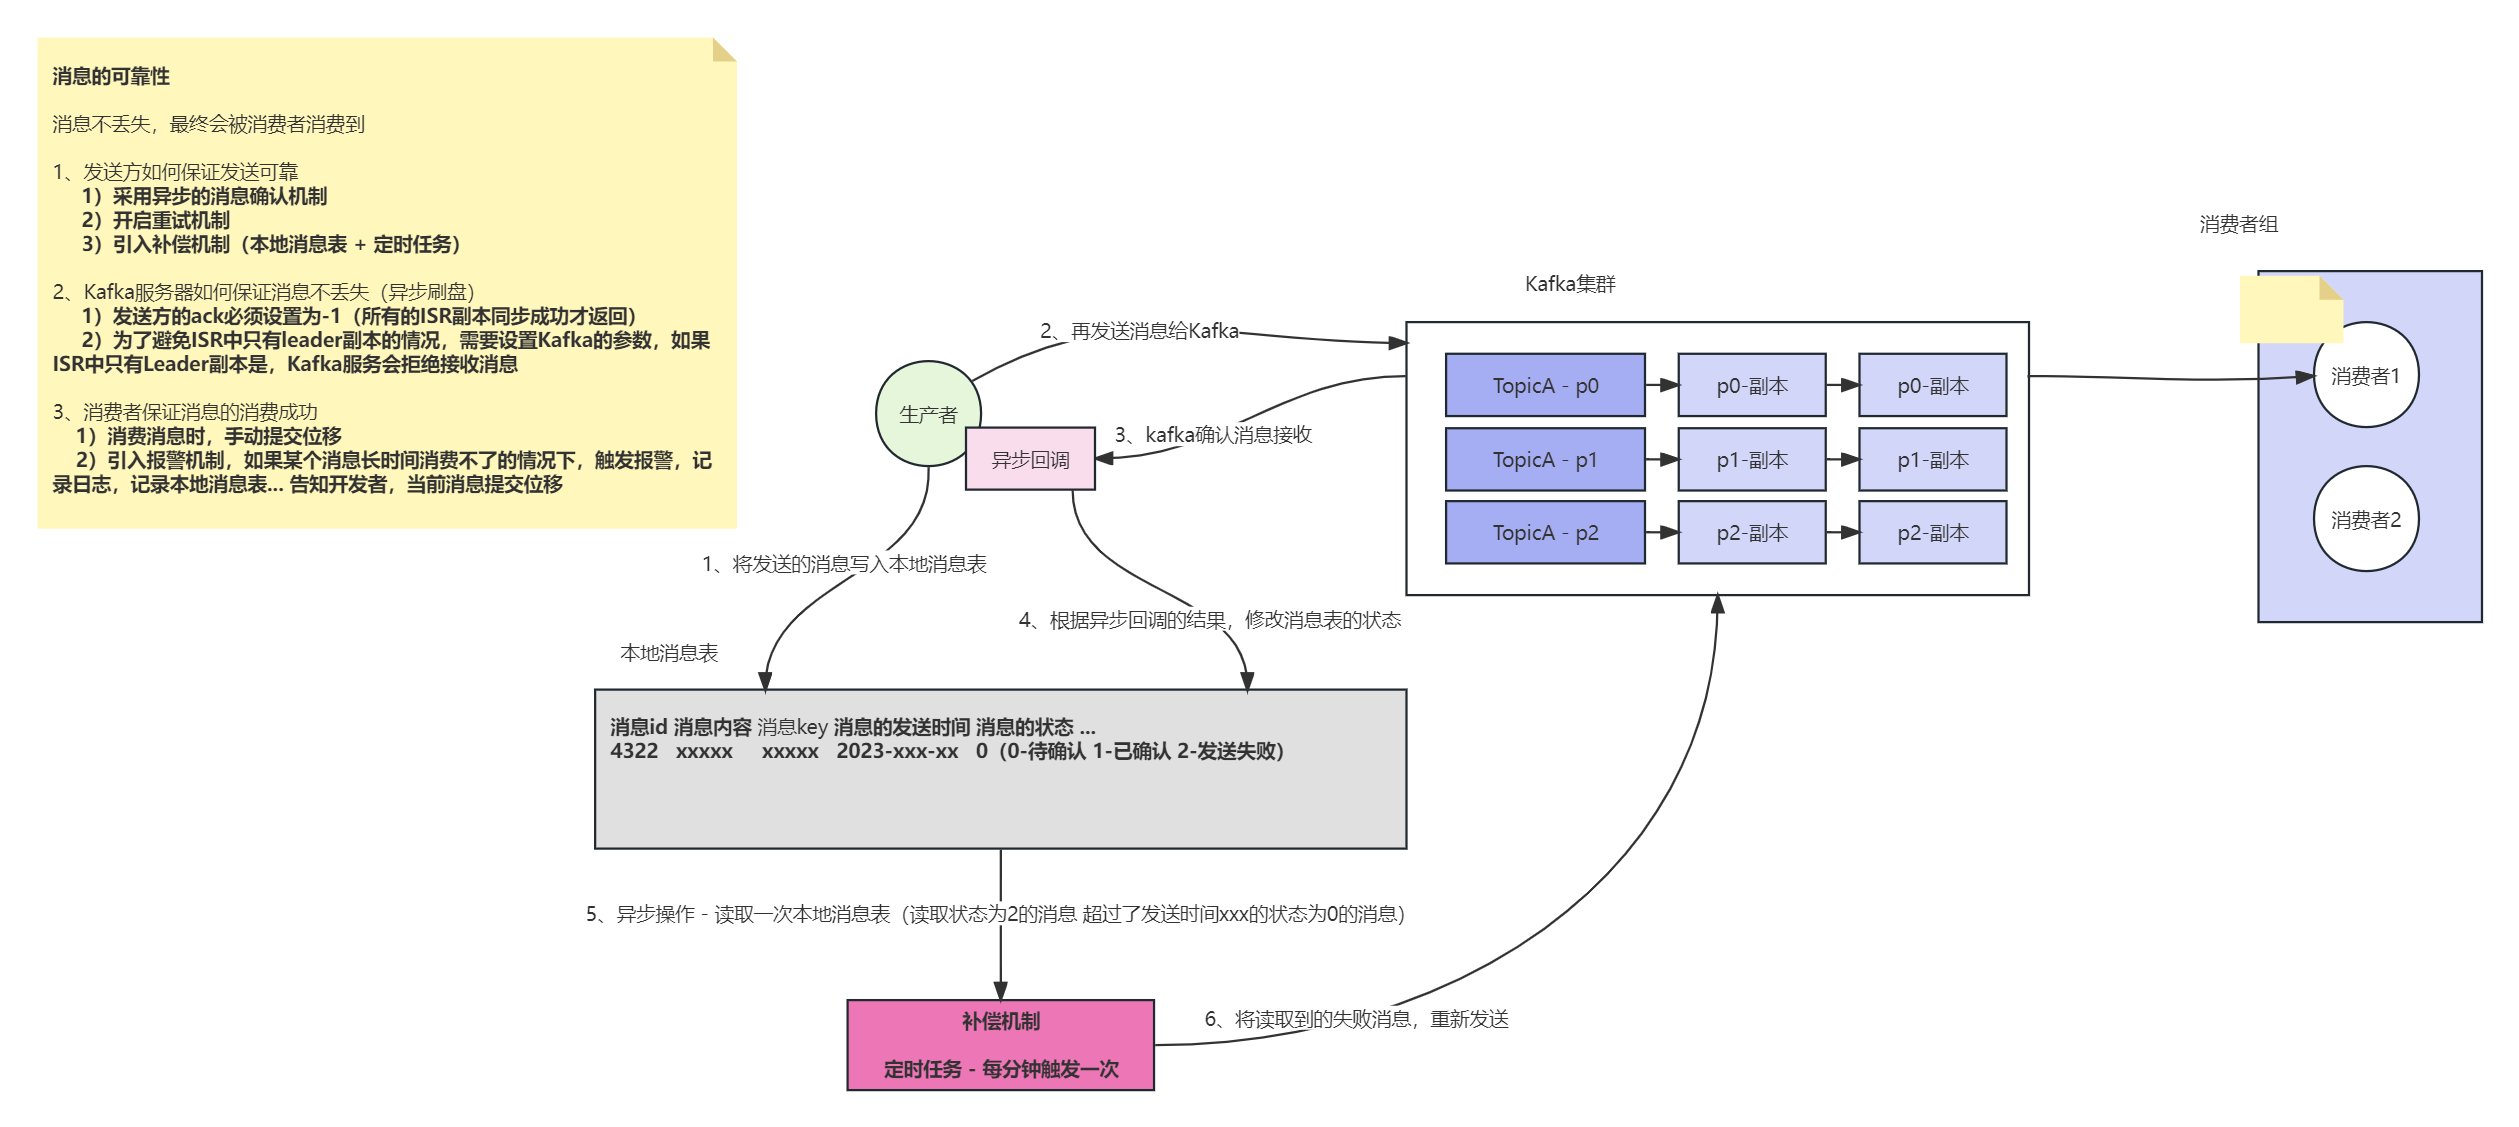
消息的可靠性必然会带来消息重复性的问题 - 消息幂等处理
3.2.3 如何保证消息的幂等性
需要保证幂等的情况
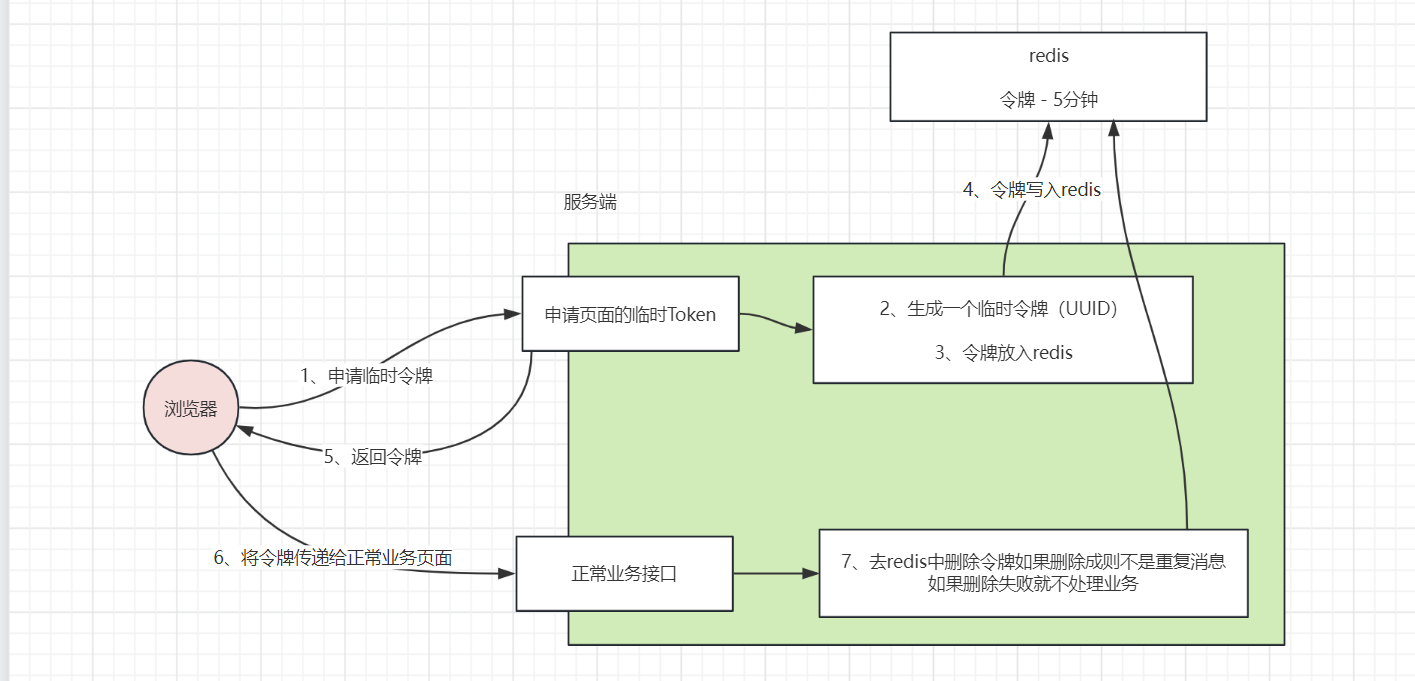
- 接口幂等
- 消息中间件消息幂等
如何保证幂等性
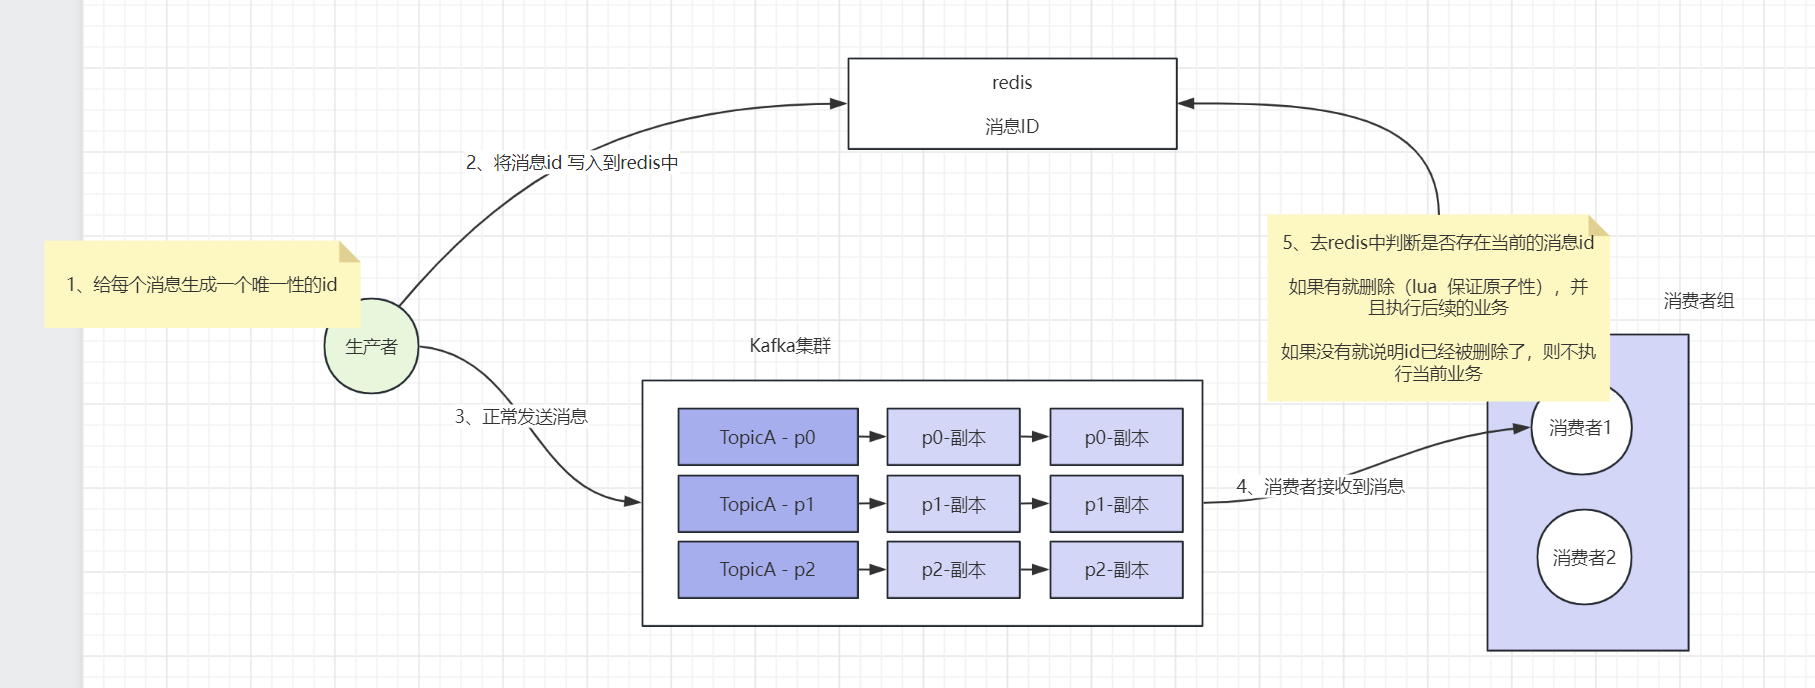
在我们原来的开发过程中, 幂等性一定是根据业务来决定如何保证的。比如,如果业务只是查询的话,那么就没必要保证幂等性。删除的业务是天然幂等。如果是新增的业务,可以依靠数据库的唯一性字段来保证幂等(有的话)。对于没有唯一性字段的新增或者修改就有可能引起重复消息的问题,对于复杂业务来说,我们也很难靠以上的方式保证幂等,这时就需要通过开发者来实现消息幂等了。通常我实现的方式,是采用消息唯一性id配合redis缓存服务器来实现消息幂等的。
消息中间件的幂等性处理
 接口的幂等性处理
3.3 Redis相关面试题
3.3.1 Redis的基本数据结构有哪些以及相关特点和运用场景?
五大基本数据类型:
- String - key:value,多用于进行数据缓存(bit位操作、BloomFilter...)
- Hash - key:{field:value,field:value....},多用于对象的存储(红包雨模块,Hash结构存储红包的信息、优惠券的信息)
- List - key:[value、value、value....],模拟分布式消息队列、分布式阻塞列表
- Set - key:[value2、value1、value5....],用来元素去重、判断某个元素是否存在
- ZSet - key:[score,value、score,value...],可以用来实现排行榜、实现排队功能或者优先级队列
其他数据类型:
- 基数(HLL)- 只会记录不重复的元素个数,通常用来进行独立用户访问量、独立IP访问量等统计
- pub/sub - 实现消息的发布订阅(类似kafka),消息不可靠,实时性比较强
- Stream(5.0)- 专门用来实现消息队列
- RedisJson模块 - 类似mongdb
- BloomFilter模块 - 判断某个元素一定不存在或者可能存在
- RedisSearch模块 - 类似ElasticSearch
.......
3.3.2 Redis的持久化方式有哪些?各有什么特点?
- RDB - 快照,会记录当前内存的一瞬间的数据信息
- 有可能造成大量的数据丢失(快照的频率有关)
- 恢复速度更快
- AOF - 只追加文件,记录所有redis执行过的写命令
- 默认关闭,需要开发者手动开启
- 有可能造成1s内的数据丢失
- 恢复速度相对较慢
- AOF文件的压缩命令 - rewriteaof (大致的原理就是将一些命令合并)
持久化方式的选择:
- 如果需要数据相对更安全,可以两个功能都开启
- 如果仅仅只是作为缓存服务器,两个方式都可关闭(配合缓存预热)
3.3.3 Redis的线程模型(6.0之前 6.0之后)
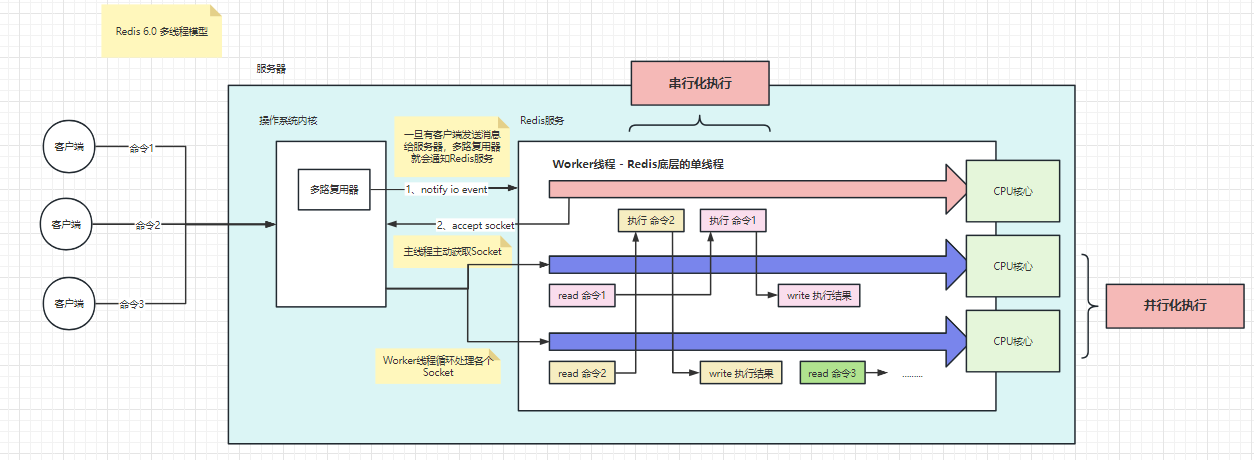
Redis6.0之前,其实一直采用单线程模型的方式执行客户端指令。在Redis6.0之后,引入了多IO线程的特性,从而进一步提高了Redis处理命令的速度。 注意:严格意义上来说,Redis6.0之前也并不是真的单线程,也会有一些子线程做扫描过期key、后台快照等工作。所谓的单线程只是指执行命令的线程为单线程
为什么Redis 6.0之前要采用单线程模型?
Redis执行命令的速度很快,并不会对CPU照成阻塞,单线程可以很好的将多个客户端的命令从并发处理变成串行处理。如果是多线程模式的话,Redis反而要考虑数据安全问题,为了保证数据一致性不可避免的要引入锁机制,反而降低了命令的执行效率,另外还要承担多线程切换的性能开销。
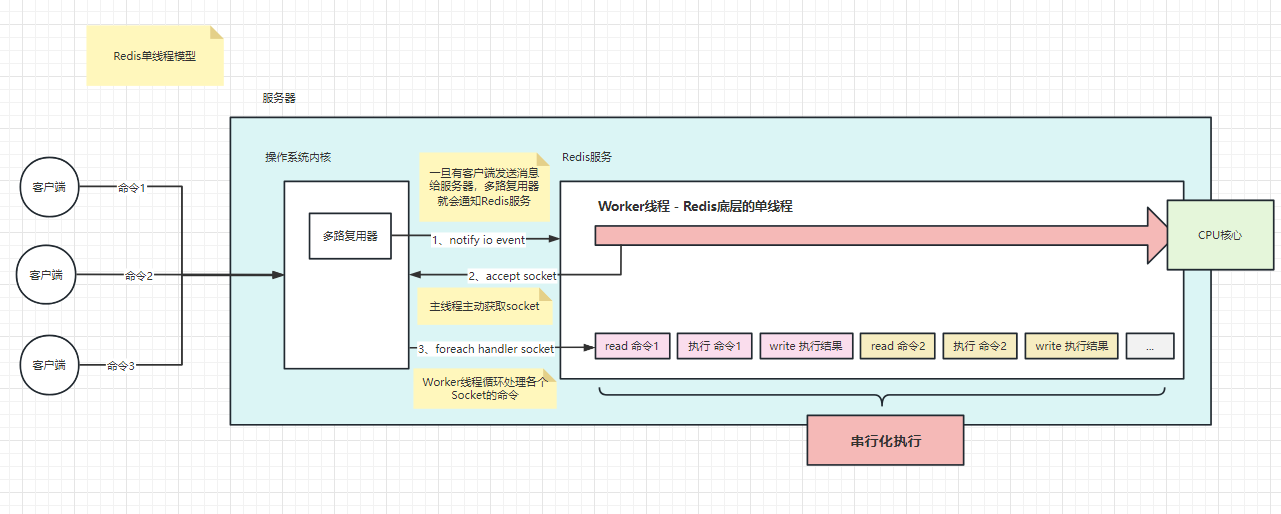 为什么Redis 6.0之后又要引入多线程模型?
Redis本身的性能瓶颈并不在CPU,而是在网络IO上,在6.0以前的版本,IO的读取与写入以及命令的执行都是由Worker线程来承担,其中IO的读取与写入占用了大量的CPU时间。而对于不同客户端的IO读写,本身没有线程安全问题,完全可以利用CPU多核的特性,提升这部分工作的并发性能,因此Redis 6.0之后引入了多IO线程的模式,来处理IO读写的任务。从单Worker线程的模型变成了单Worker线程 + 多IO线程的模型。
3.3.4 Redis lua脚本的作用以及运用场景
基于Redis是单线程模型,但是客户端的多条命令并不能保证线程安全。为了解决这个问题,Redis引入了Lua脚本。对于一个Lua脚本来说,Redis会看成一个整体,全部执行或者全部不执行。因此我们可以将一个业务封装成一个Lua脚本,交给Redis执行,这个Lua脚本具有原子性,不能担心线程安全问题。可以实现无锁化的并发操作。 运用场景:
- 网关限流(令牌桶算法)
- 分布式锁(Redssion底层就是Lua脚本)
- 红包雨(抢红包的逻辑 - Lua脚本)
- BloomFilter(通过lua脚本封装调用BloomFilter的API)
......
3.3.5 Redis在实际开发过程中的运用场景
- 缓存服务器
- 分布式锁服务器(Redis、Zookeeper、数据库)
- id自增序列
- 数据共享(用户信息)
- 线程安全的业务处理(红包雨 - lua脚本)
3.3.6 缓存相关的问题(缓存击穿、缓存穿透、缓存雪崩、一致性问题、热key、大key问题.....)
1)缓存穿透
客户端恶意的访问一个不存在的数据,从而穿透缓存,请求到达数据库,频繁的发送这类请求,直接查询数据库,增加数据库的压力。
解决:
1、在缓存服务中缓存null值 2、用户黑名单 3、使用布隆过滤器(判断,一个数据可能存在或者一定不存在)(布隆过滤器 = 位数组 + N个哈希函数)
2)缓存击穿(缓存失效)
某个热点缓存失效之后,大量的请求访问该数据,在第一个请求重建缓存回来之前,大量的请求发现缓存失效,都会去尝试重建缓存,从而导致数据库压力增加。
解决:
1、如果确定某个key是热点key,并且修改频率较低的情况下,可以设置为永不过期 2、在重建缓存时,添加分布式锁(双重锁校验)
3)缓存雪崩
大量的缓存,在同一时刻一起失效;或者Redis服务宕机,导致大量请求同时请求数据库,增加数据库压力。
解决:
1、新建缓存时,采用固定 + 随机数的方式设置过期时间,打散Key的过期时间。 2、Redis服务必须集群部署,保证服务的高可用性(读写分离、数据分片等)
4)缓存预热
在项目运行之前,分析出热点数据,直接添加到缓存服务器中。如果不进行预热,那么redis初始状态数据为空,系统上线初期,对于高并发的流量,都会访问数据库,会对数据库造成流量的压力
5)缓存一致性问题
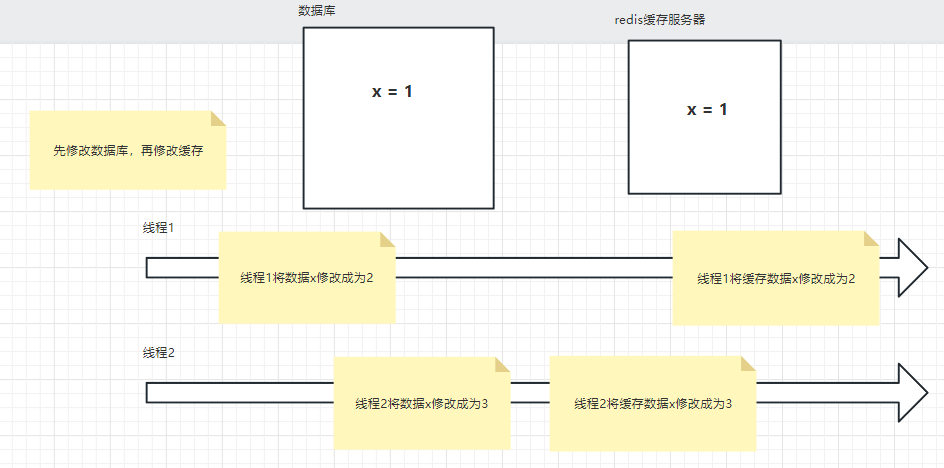
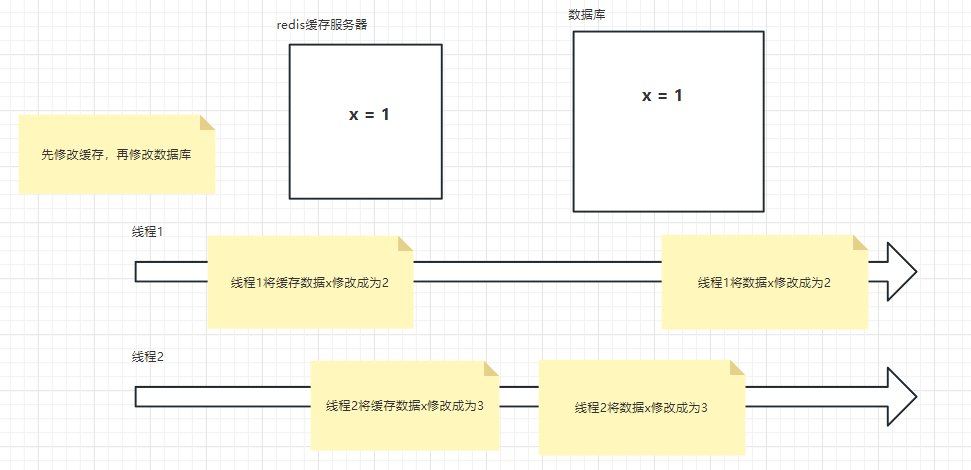
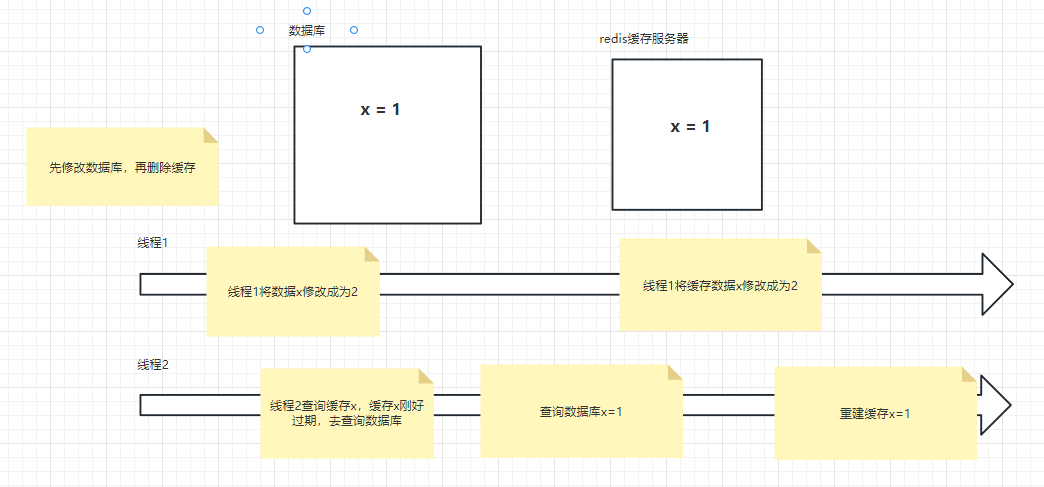
缓存一致性问题是指当数据库中数据被修改后,如何保证Redis中缓存数据的准确性。 一般修改数据库和缓存数据的方案:
- 先修改数据库,再修改缓存
- 先修改缓存,再修改数据库
- 先修改数据库,再删除缓存
- 先删除缓存,再修改数据库
这些方案都各有问题:
- 先修改数据库,再修改缓存
- 先修改缓存,再修改数据库
- 先修改数据库,再删除缓存
- 先删除缓存,再修改数据库
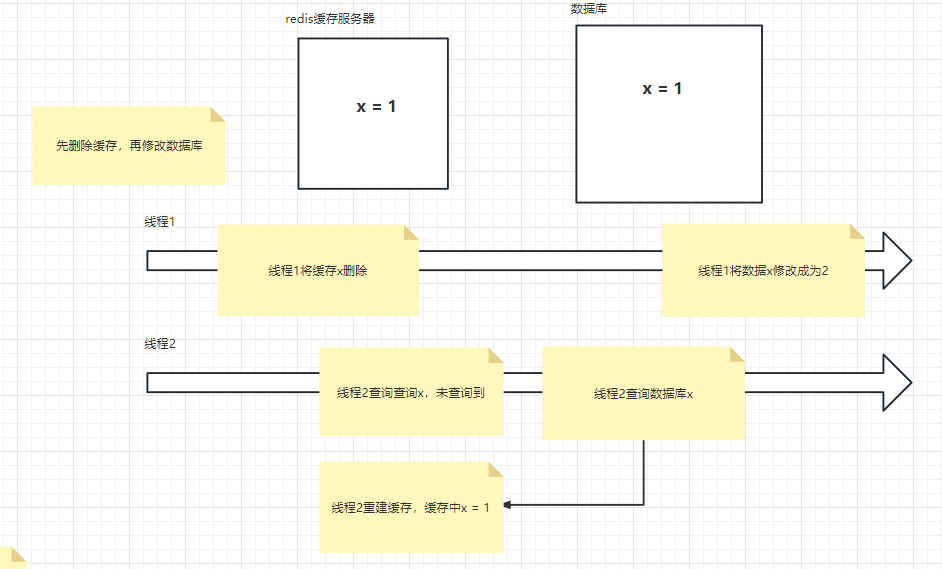
以上列举了各种方案可能存在的问题,但是相对来说先修改数据库,再删除缓存方案,出现问题的概率极低,所以实际开发过程中可以选择该方案来保证缓存一致性。另外,缓存数据一般都有过期时间,所以,如果发生极端情况,出现了缓存不一致的情况,也有过期时间兜底,最终数据还是会保持一致。 其他的一致性保证方案:
- 延迟双删 - 更新数据 -> 删除缓存 -> 延迟队列异步(再次删除缓存)
- 基于阿里的cancel服务,cancel服务会自动读取数据库的binlog文件,监听数据库的修改,一旦发现数据库变化,自动去修改缓存服务器,开发者的业务中无需考虑处理数据库和缓存一致性问题。
6)热key问题 什么是热key问题?
实际开发过程中,Redis通常会搭建分片集群。数据散落在不同的Redis节点上。但是如果某些key过于热点,大量的请求同时访问,则会导致集群中这个key所在的机器访问量远远超过其他的机器,特别是一些热点key同时落在一台机器上的情况时,将加剧这种情况的发生,导致流量过于集中于这台机器,从而导致这台机器的假死甚至宕机,轻则影响这台机器其他key的访问,重者可能导致缓存击穿甚至雪崩,最终拖垮数据库。这类问题称之为热点key问题。 解决热点key问题大概分为两个阶段:发现热点key、对热点key进行特殊处理
如何发现热点key?
- 通过业务经验判断热点key,比如一些热门商品、秒杀商品场次等缓存信息
- 业务层访问数据时统计收集
- 构建一个缓存代理层,代理层负责收集key的访问频率周期等信息
解决方案
- 单独搭建读写分离集群,热key数据用读写分离集群缓存
- 搭建多级缓存结构(后面介绍)
7)大key问题
当一个key对应的value占用空间巨大时,就称之为这个key为大key,称之为大key其实是大value问题。当String类型的value超过10KB,List、Set、Hash、ZSet元素数量超过5000,都可以称之为大Key
大key的危害
- 对于大key的查询更慢,容易照成请求阻塞
- 删除大key比较耗时,也会照成请求阻塞
解决方案
- 对于String类型的大key,可以采用value压缩的方式进行存储
- 对于List、Set、Hash、ZSet类型,可以采用数据拆分的方式进行存储
8)多级缓存策略 什么是多级缓存(二级缓存)?
就是在redis缓存(分布式缓存)基础上加上服务器缓存(本地缓存),利用本地缓存更加高效的特性,进一步提高业务响应速度。
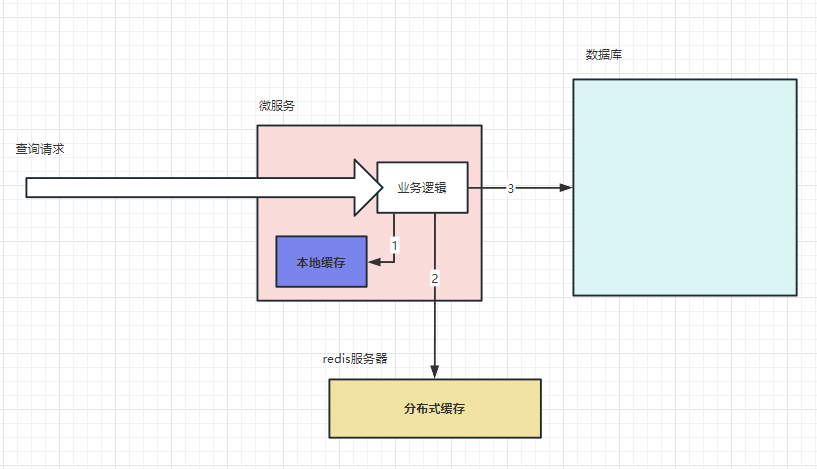 多级缓存的优势
- 数据库的QPS - 几千/s
- Redis的QPS - 十万左右/s
- 本地缓存的QPS - 50W+/s
- 多级缓存可以更好的提升查询性能
- 多级缓存可以很好的解决热key问题
多级缓存的问题
更多的缓存虽然进一步提升了查询性能,但是也同样带来的更为复杂的缓存一致性的问题 解决方案:本地缓存的删除可以通过发布/订阅的方式通知其他的机器删除本地缓存(pub/sub)
本地缓存的选择
- ehcache
- guava
3.3.7 多级缓存的设计与相关问题
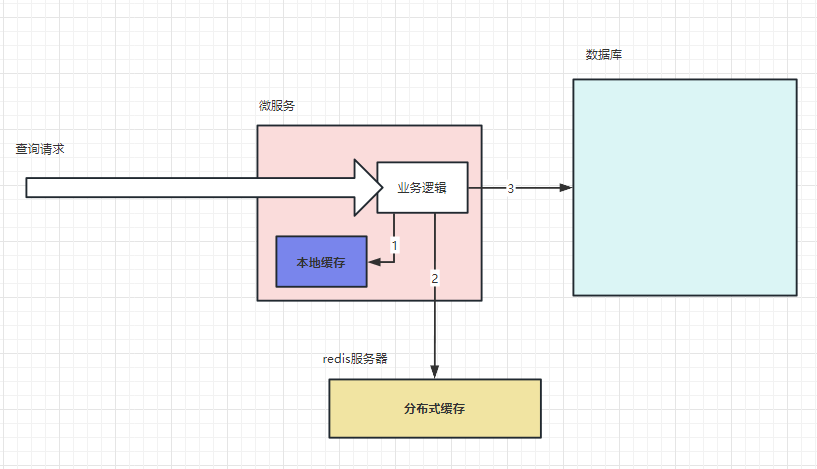
自定义注解 + AOP + ehcache + Redis + 分布式锁(避免缓存失效后,大量请求同时重建缓存)
3.3.8 Redis集群的方式有几种?各有什么特点
- 读写分离(主从复制 + 哨兵模式)
- 基于主从复制
- 适用于读多写少的场景
- 基于哨兵模式保证高可用
- 哨兵有两个功能:故障自动切换、实现请求的读写分离
- 缺点:读写分离集群不能拓展服务器的存储容量
- 分片集群
- 类似于一张大的哈希表,(0~16383的插槽)
- 集群中节点之间两两互相通讯
- 随着节点的增加,集群整体存储容量也会增加
- 每个节点都可以配置多个备机
3.3.9 Redis实现分布式锁的方案,以及常见问题(锁丢失的问题)
- setnx - 简单,但是如果业务的执行时间超过了锁的过期时间时,有可能导致数据一致
- redisson - 第三方的框架,通过watch dog可以自动延续key的过期时间
锁丢失的问题:
redis无法避免锁丢失,因为redis是AP设计。比如在主获取锁成功后,突然宕机,或者脑裂情况发生时,都可能导致主从数据不一致,并且产生两个主的情况,这时多个服务都有可能同时获得锁。这种情况称之为锁丢失的问题 解决方案:
- 使用zookeeper来实现分布式锁
- 可以使用redisson中的redlock(过时)- clusterlock
四、项目模块介绍
4.1 分布式登录
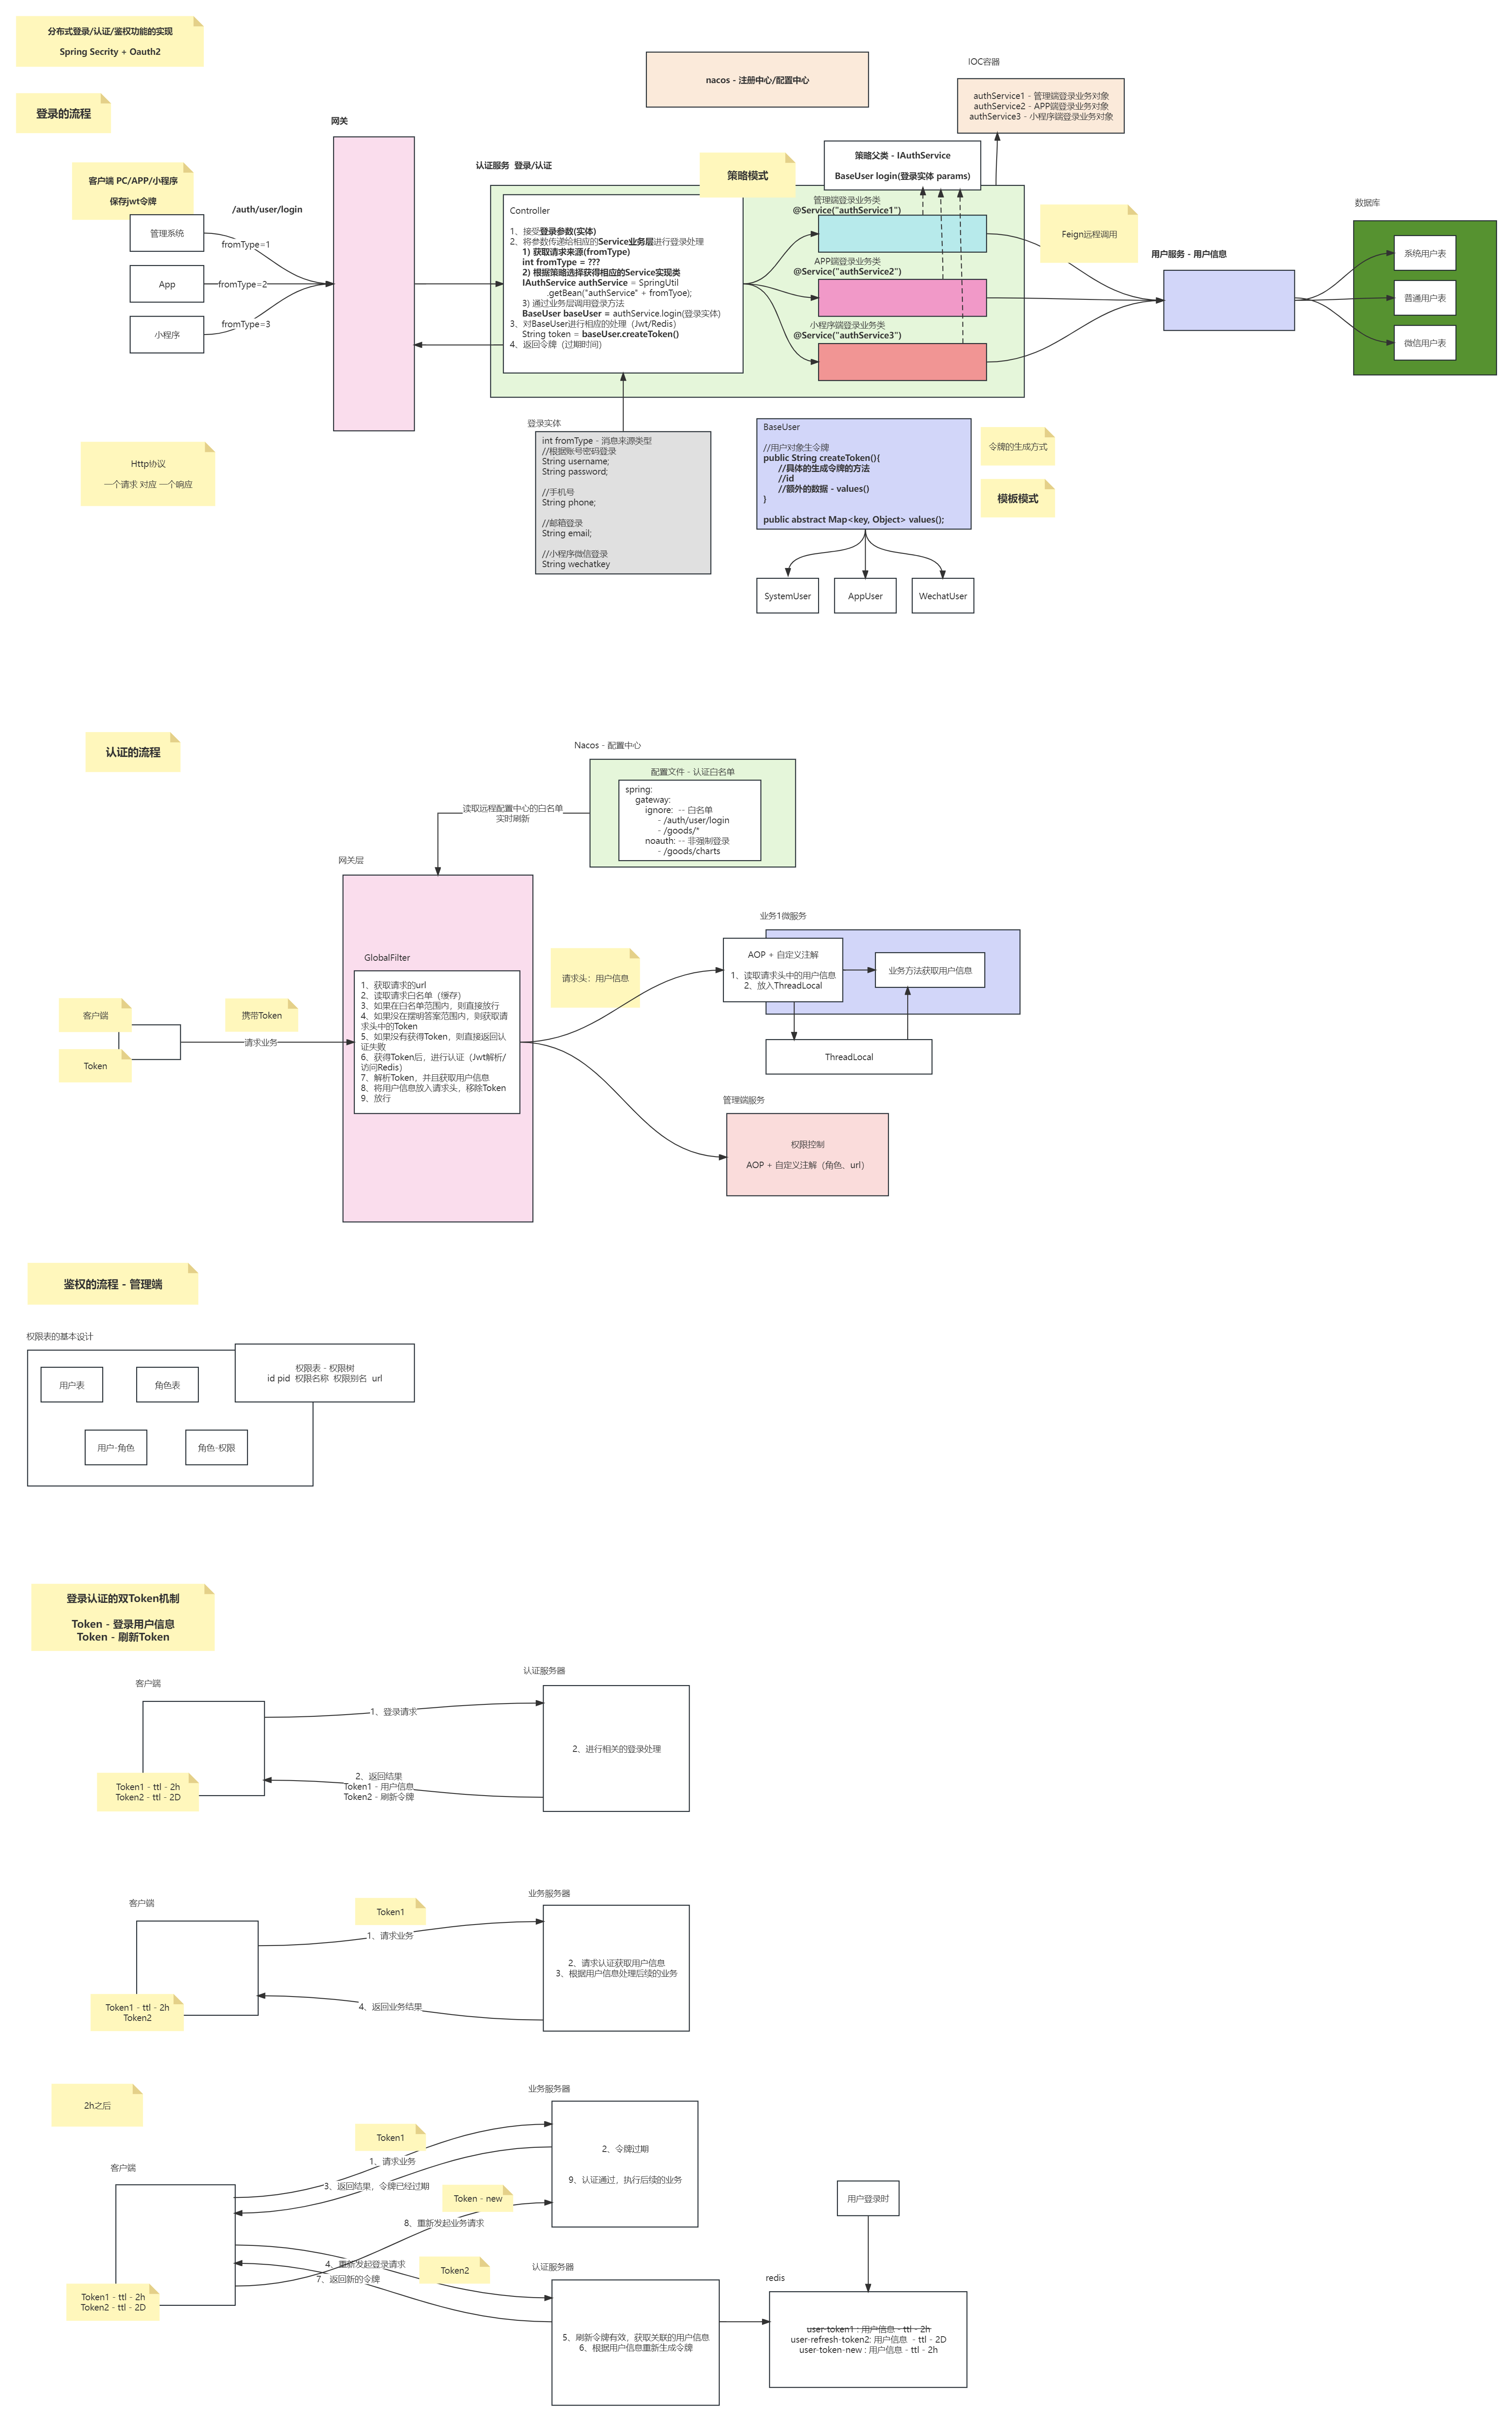
讲一下曾经xxxx项目中,自己设计实现的分布式登录模块。因为这个项目刚立项,从0开始,架构选择的是SpringBoot + SpringCloud实现的微服务架构体系。需要实现一个分布式登录,当时团队讨论,因为某些原因,没有选择第三方太重的一些安全认证框架,比如SpringSecurity等,而是自己设计实现的一套登录流程。项目采用的是前后端分离的架构,前端的形式比较多样性,有小程序、有网页、也有App。每一端,登录的过程也不尽相同。比如,后台系统采用用户密码登录,而小程序采用微信登录,另外网页采用手机号或者APP扫描登录等.... 因此我们后端会创建一个认证服务,专门用来统一管理所有的登录请求,不同的请求方式,需要传入一个fromType参数,告诉后端,登录的类型是什么。而我在做后端设计时,也是用了策略模式,通过的登录流程,会有一个不同的业务实现类,业务实现类的名称和fromType的类型是挂钩的,在登录时,结合客户端的请求参数,会自动选择不同的实现类来实现登录流程。统一登录接口也会返回一个共同的用户抽象类,使用Jwt对当前用户信息(过滤了一些敏感信息、id、昵称、头像)生成一个Token令牌,返回给客户端,客户端保存到本地即可,这就是整个登录的过程。如果客户端需要进行相关的业务请求(认证的过程),要求客户端必须携带本地保存的登录Token,通过网关层进行拦截。网关首先会去Nacos上获取放行列表,以此判断当前请求是否需要登录。如果需要登录,再获取Token令牌,进行Jwt校验,如果校验失败,在一天以内,可以进行续签的操作,生成一个新的Token,返回给客户端。如果超过1天,则需要提醒客户端重新登录。如果校验通过,则会将用户信息放入请求头,传递给后端的业务微服务。而每个业务微服务,我都统一设计了一个AOP,通过一个自定义注解可以开启AOP,这个AOP会拦截前置请求,从请求头中解析出用户信息,放入ThreadLocal,这样的话,后续的业务就可以从ThreadLocal中获取到用户信息,完成业务流程,这就是整个认证的过程。如果需要进行权限控制,则只需要在网关层,去redis中获取用户的权限列表,和当前请求地址匹配即可,如果没有匹配上,说明当前用户没去权限,直接驳回即可。
4.2 红包雨活动设计
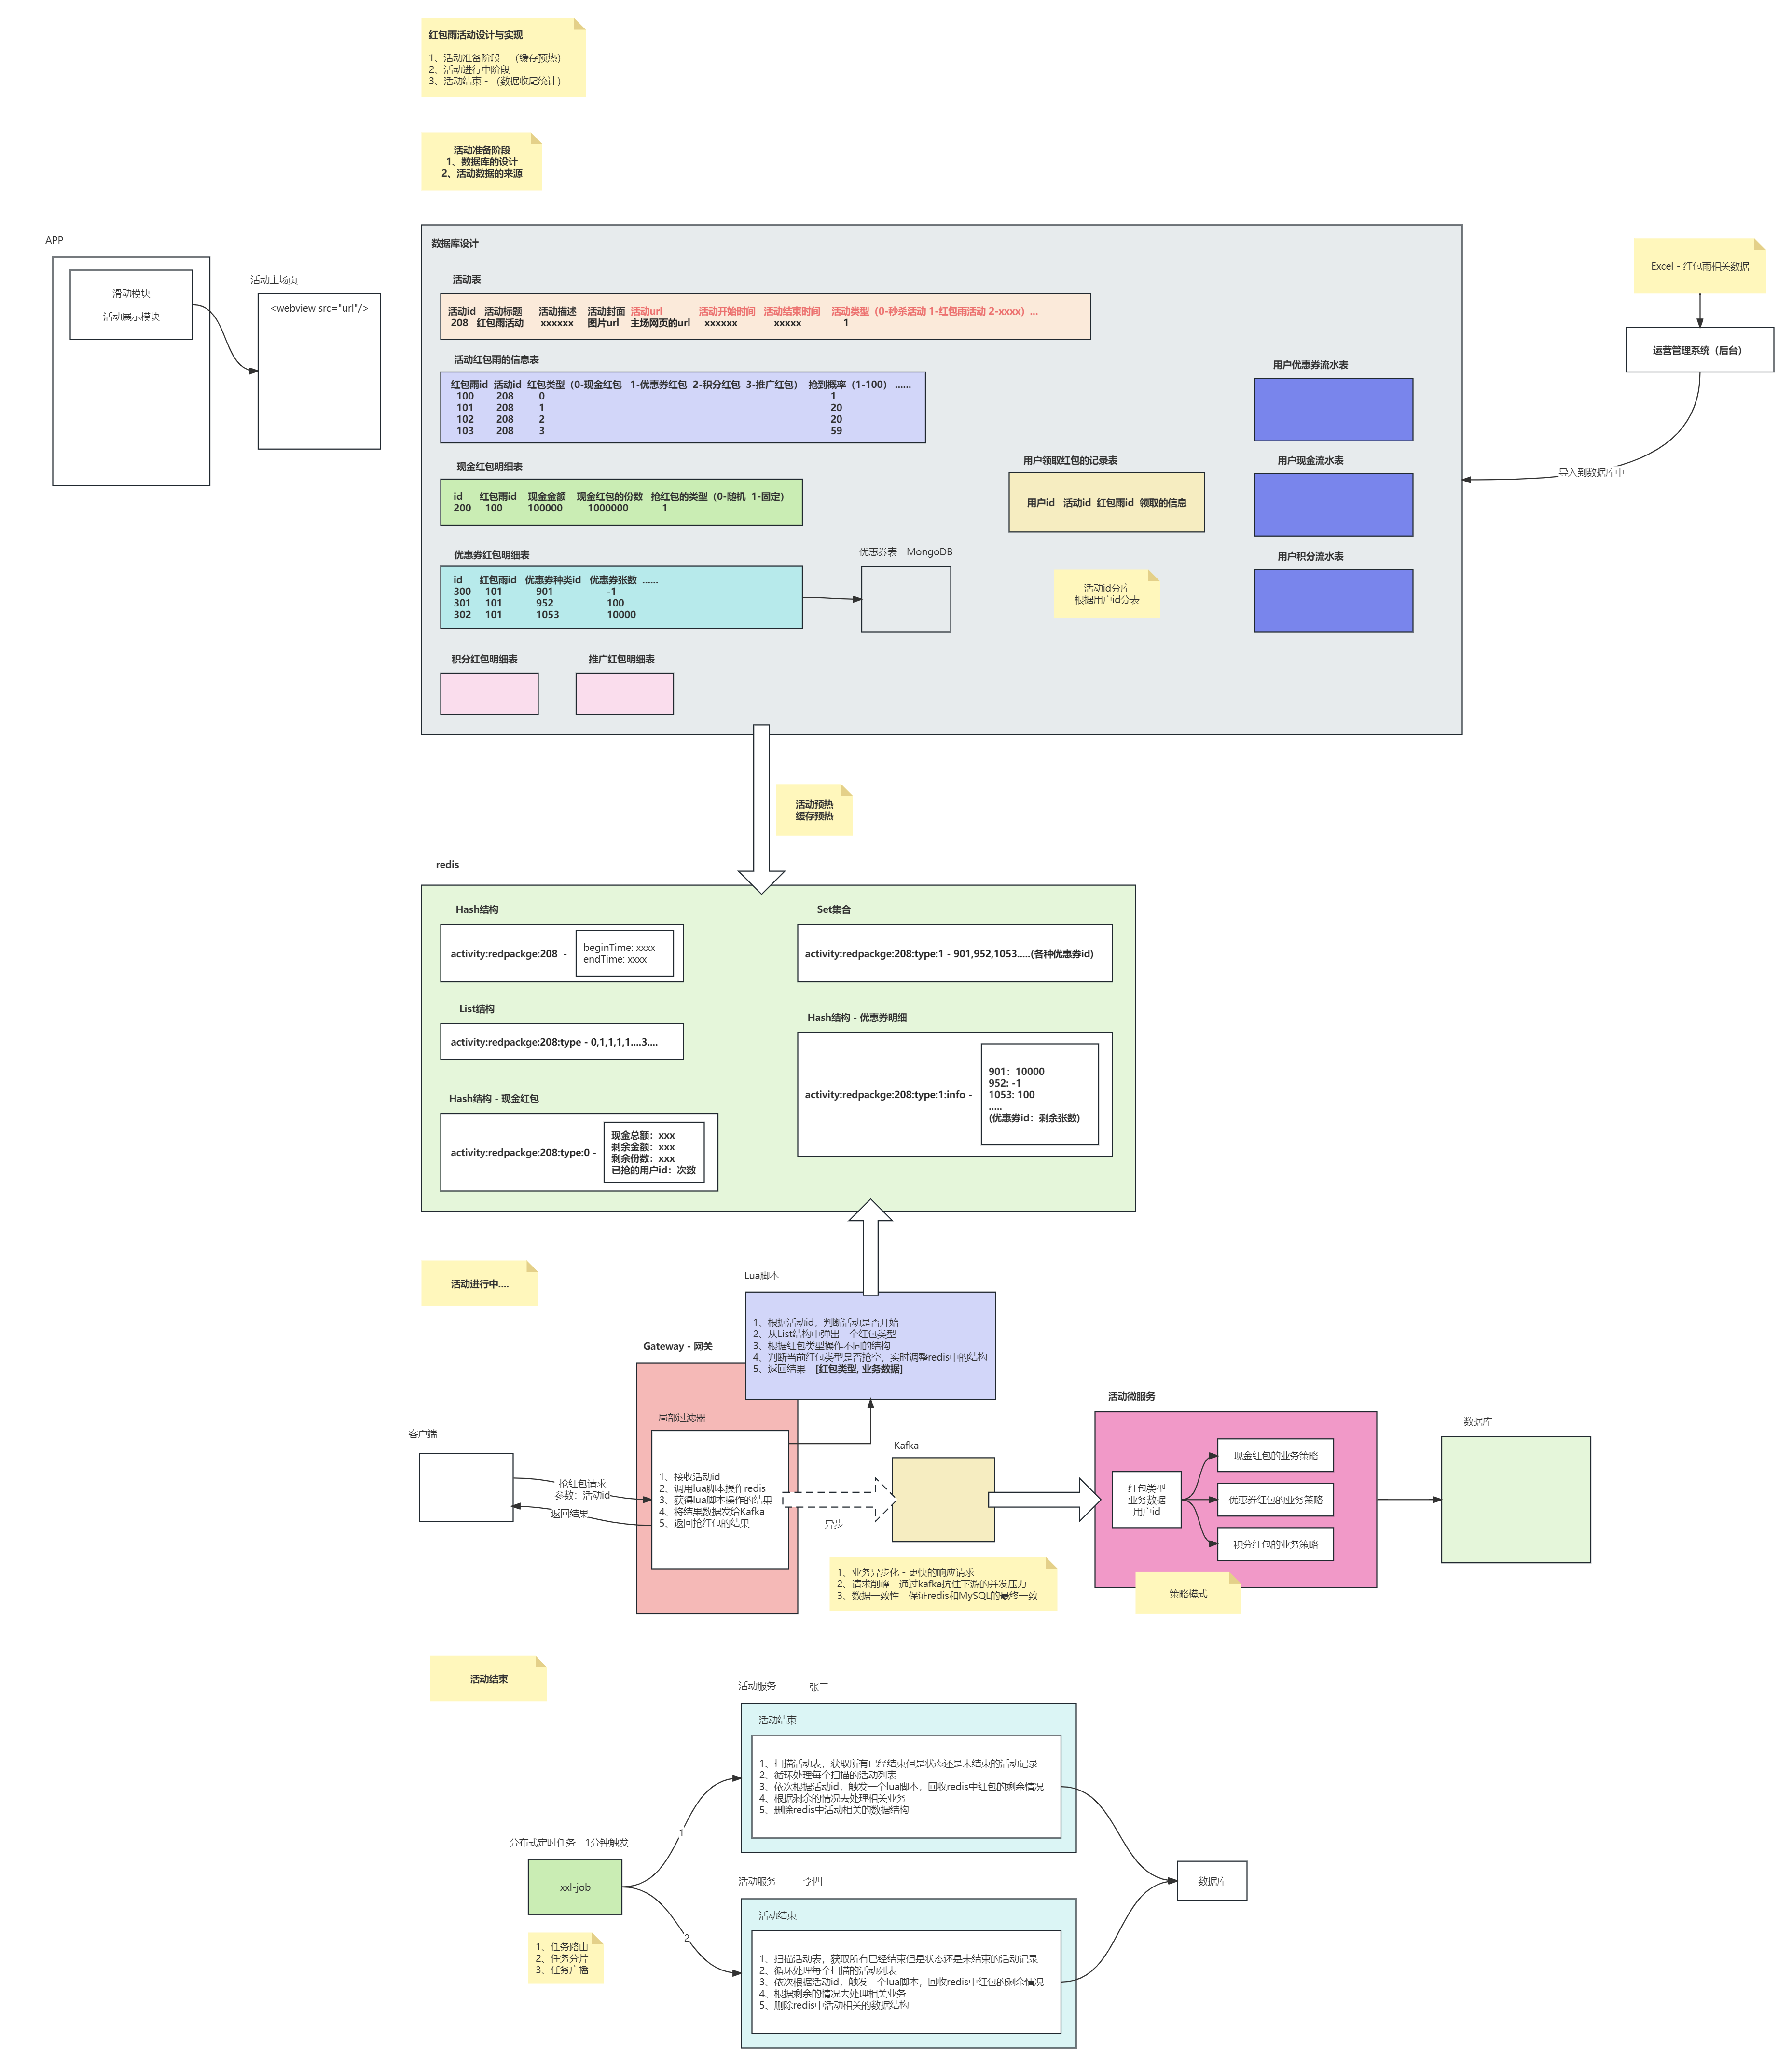
介绍下最近项目中,自己独立设计开发的一个红包雨模块。原项目中,没有红包雨的活动,产品在某个版本上,提出了相关的需求。这块就是由我负责主导设计开发。大概的需求就是,在一些相关的节日活动中,公司的APP的会推出相应的节日活动,红包雨就是其中的一种。首先,整个红包雨的活动可以分为几个阶段,第一就是活动准备阶段,这个也是相对最麻烦的阶段,需要提前的导入或者准备相关的数据,比如优惠券、合作推广信息等。第二就是活动开始后的抢红包的阶段,这个阶段相对请求量会比较高,需要考虑服务器的性能和数据一致性问题。第三就是活动结束后一些数据同步收尾。首先,活动准备时,会准备一些红包雨中的红包数据,在我们的项目中,初期设计的红包类型有三种,分别是现金红包、优惠券红包、以及推广红包,后期也支持动态的拓展红包类型,不同的红包类型,抢到后的处理方式也是不一样的。在准备的阶段过程中,为了让运营人员更好的填充红包数据,设计了一个导入模块。我们会提供一个Excel模板,运营人员可以根据模板的格式,填写相关的数据 (优惠券、推广信息等),然后再导入到系统中。为了提高导入的性能,当时这里也设计了一个线程池分批导入的功能。数据入库之后,在活动开始前,运营人员可以选择某个活动进行提前预热,所谓的预热,会将相关的红包信息和数据全部导入的redis里,为抢红包做准备。不同类型的红包,在redis中的结构是不太一样的,比如现金红包,我们是在redis中用一个Hash结构进行存储,用来存储现金的金额以及份数。而优惠券的红包,我们是使用了Set结构和Hash结构进行配合存储的,Set结构用来记录优惠券的种类id,而Hash结构用来记录优惠券的相关数量。当红包雨活动开始时,因为在预热阶段,我们就通过Hash结构将活动id和活动开始结束时间都缓存到Redis中了。这时抢红包的请求就可以通过当前时间判断活动是否已经开始,从而进行抢红包的逻辑。整个逻辑的实现,我们是放在Gateway网关层中,而且为了保证性能和数据安全,统一采用一个Lua脚本进行抢红包的逻辑实现的,比如判断当前抢到的红包类型,根据对应的红包类型去处理相关的红包数据。因为Lua脚本本身是一个整体,而Redis是单线程执行命令的,所以可以在不用加锁的情况下,保证Redis中整体红包数据的安全一致性,以此来提高性能。当redis中确定抢到某个红包后,将红包的相关信息返回,网关直接将抢到的红包信息返回给客户端,以此来减少和数据库的交互,同时降低单个请求的响应时间,保证单台服务器的并发量。为了数据的安全,因为redis中的数据毕竟不是一个非常可靠的环境,采用通过Kafka异步通知的方式,将用户抢到的红包数据,通知给后面的活动服务,活动服务再将数据同步到数据库里,保证数据的最终一致性。这里的Kafka同时还起到请求削峰的作用,在前端并发压力相对比较大时,可以控制活动服务的消费速度,保证数据库的正常运行。大概的设计思路与实现差不多就是这样,我们自己在做压测时,单台服务器的情况下,红包雨的总红包数有10W左右,一万左右的请求时,可以在10秒左右处理完成
4.3 基于用户行为的智能推荐系统
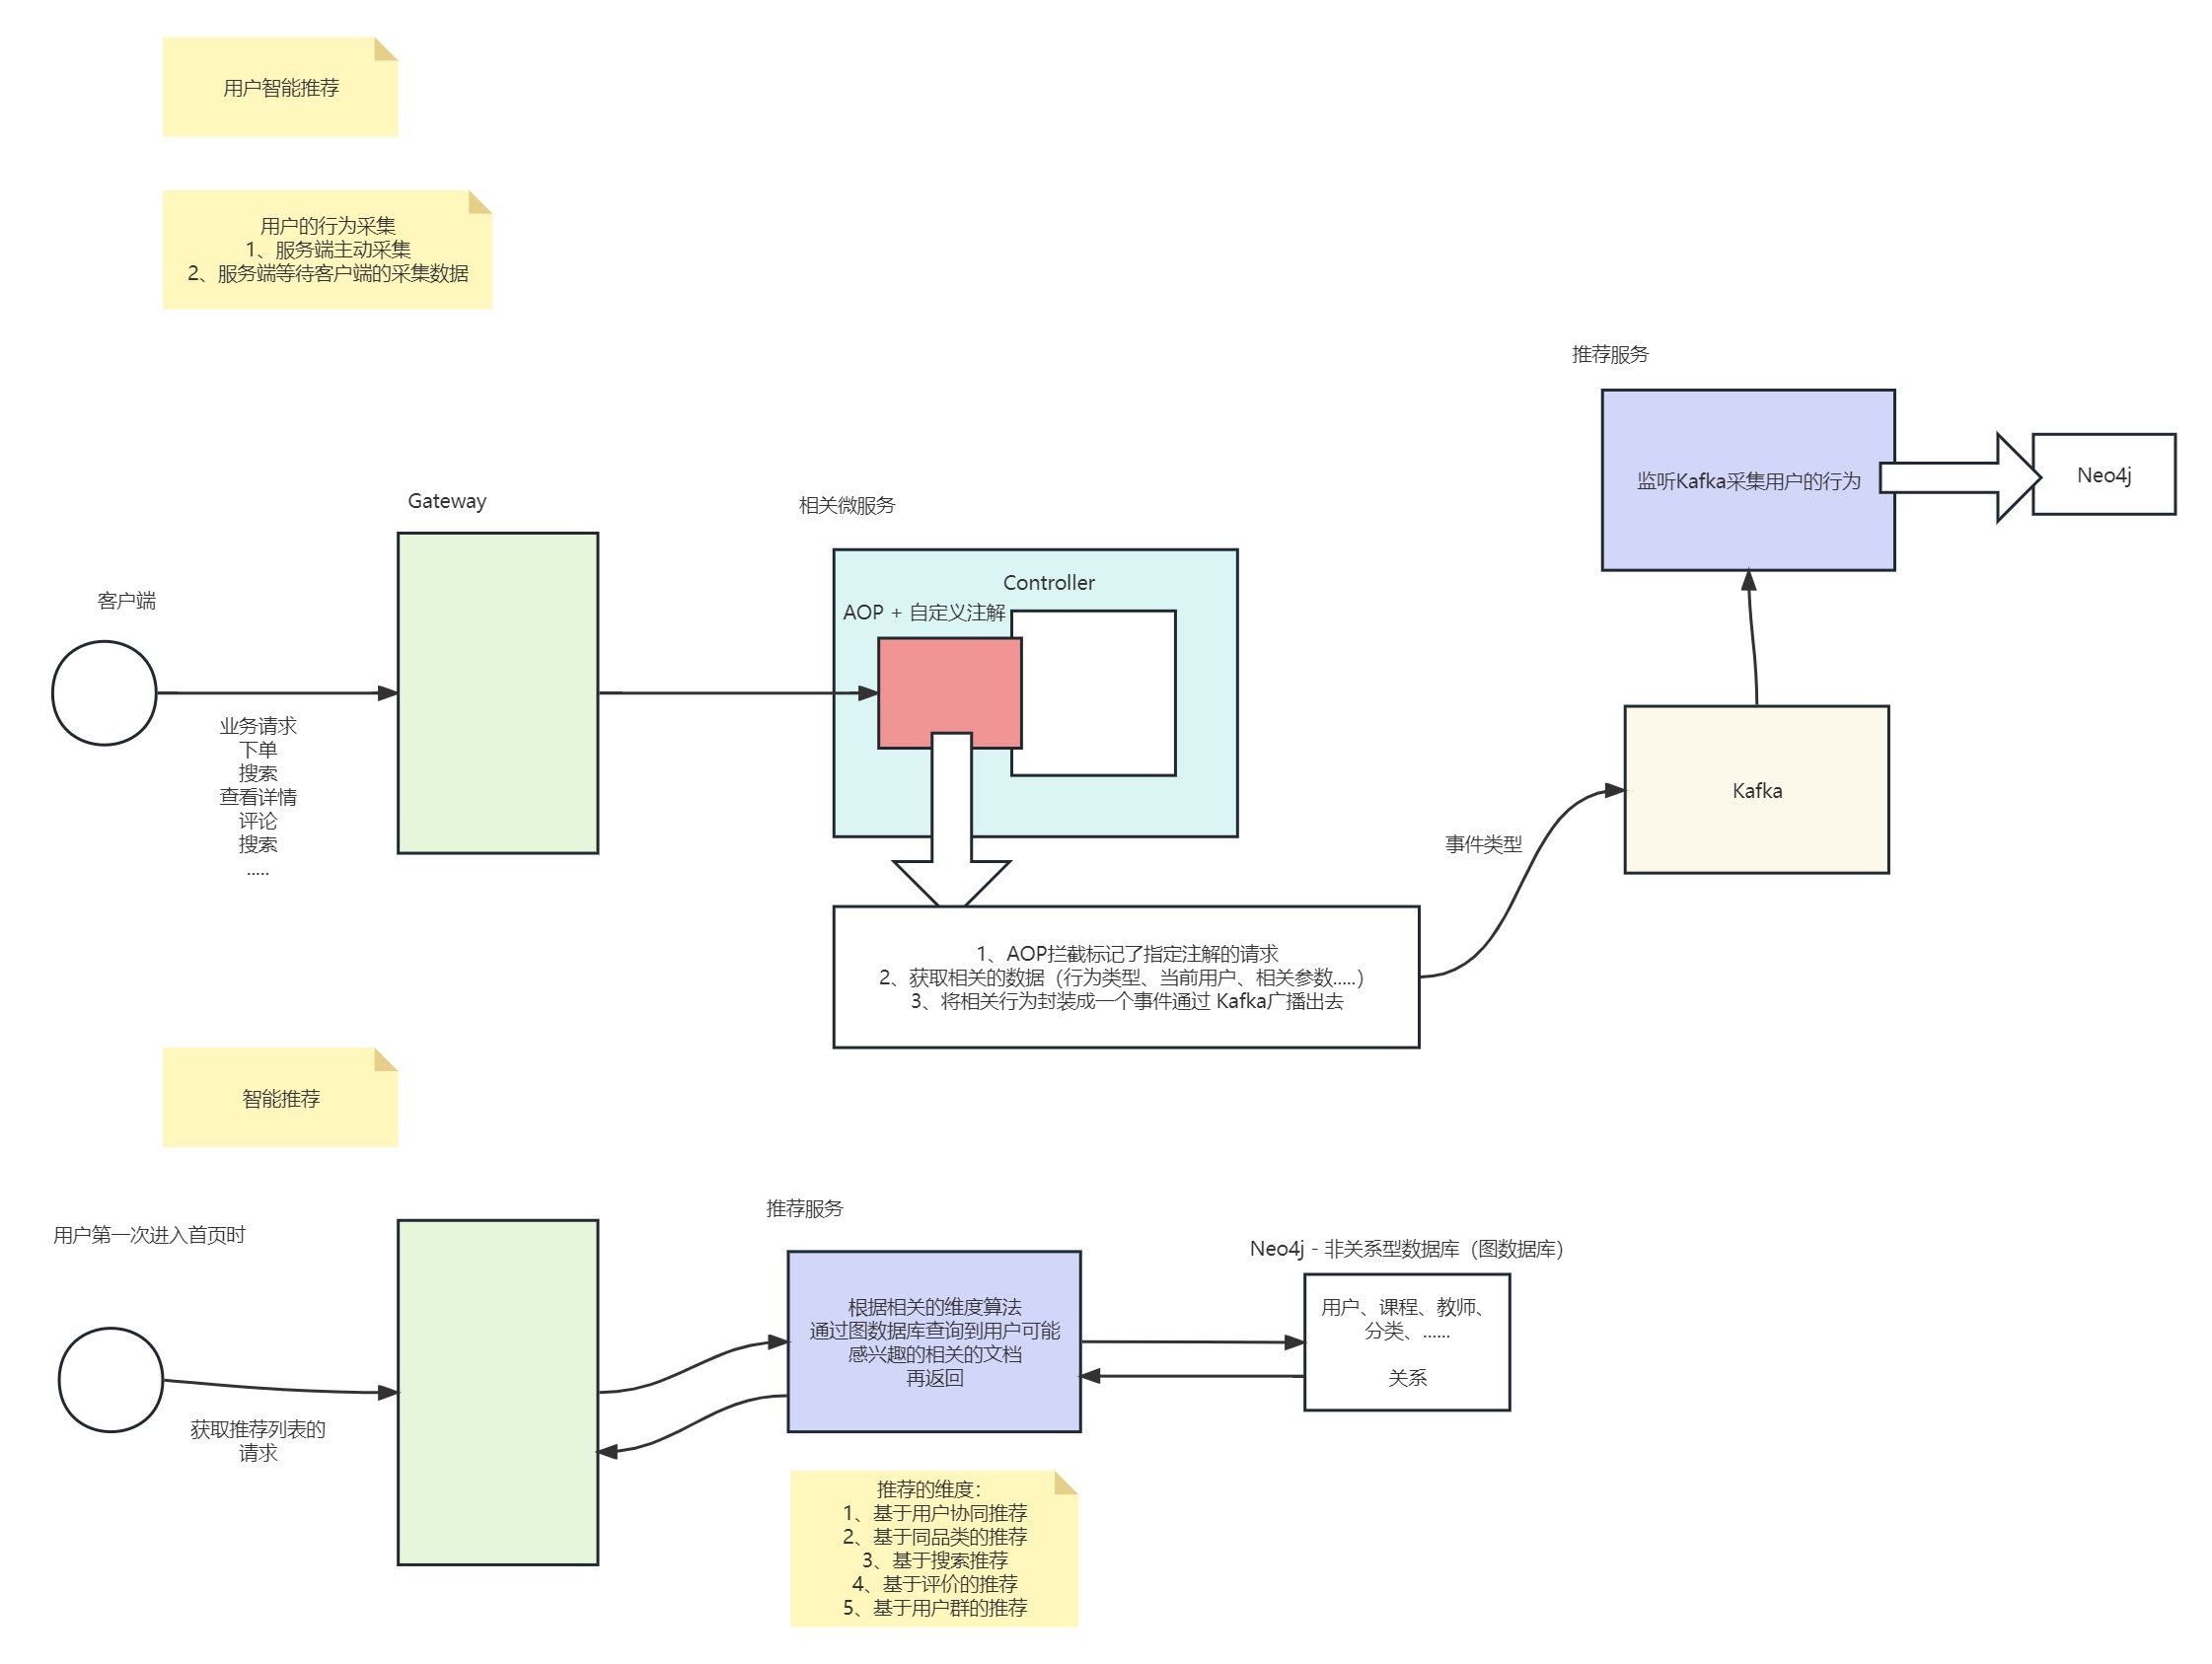
介绍下Xxx项目中实现的一个智能推荐的模块,关于智能推荐的功能,大致可以分为两大块,一块是用户的行为采集,具体是通过自定义注解配合AOP来实现。通过自定义注解,结合AOP环绕增强,实现用户请求拦截,获取请求用户信息、参数、行为枚举等,再将相关数据统一发送给kafka,由推荐服务监听接收,入库保存。另一个块是就是关系维护,推荐算法分析,这块我们是通过Neo4j图数据库来实现的,通过图结构,维护各个节点之间的各种复杂的关联关系。比如课程属于哪个分类,用户购买或者关注了某个课程,用户评价了某个课程,用户搜索了某个关键词等等,这些关系的来源就是通过前面提到的用户行为采集,采集到的数据最终会录入到Neo4j中,形成这种关系图谱。有了这个图谱后,就可以通过CQL语句结合各种推荐的逻辑算法查询出相关的推荐课程。具体推荐的维度大概可以分成几种,比如基于用户的协同推荐、基于同分类的课程推荐、基于搜索词的相关推荐、基于共同评价的推荐以及基于用户群的推荐。这种基于Neo4j的图谱关系维护的推荐方式,极大得到提高了关系与关系之间的查询效率,降低了关系的维护成本,在海量数据与复杂的关系面前,比传统的关系型数据库的维护成本更低,同时查询效率更快。曾经公司做过一个压测,传统关系型数据库在一个复杂关系的维护中,大致有8到10张表左右,平均每张表几十万条记录左右,一个复杂的关联查询需要分钟级别,但是将数据导入到图数据库上,毫秒级就可以返回结果。
4.4 海量数据的分库分表
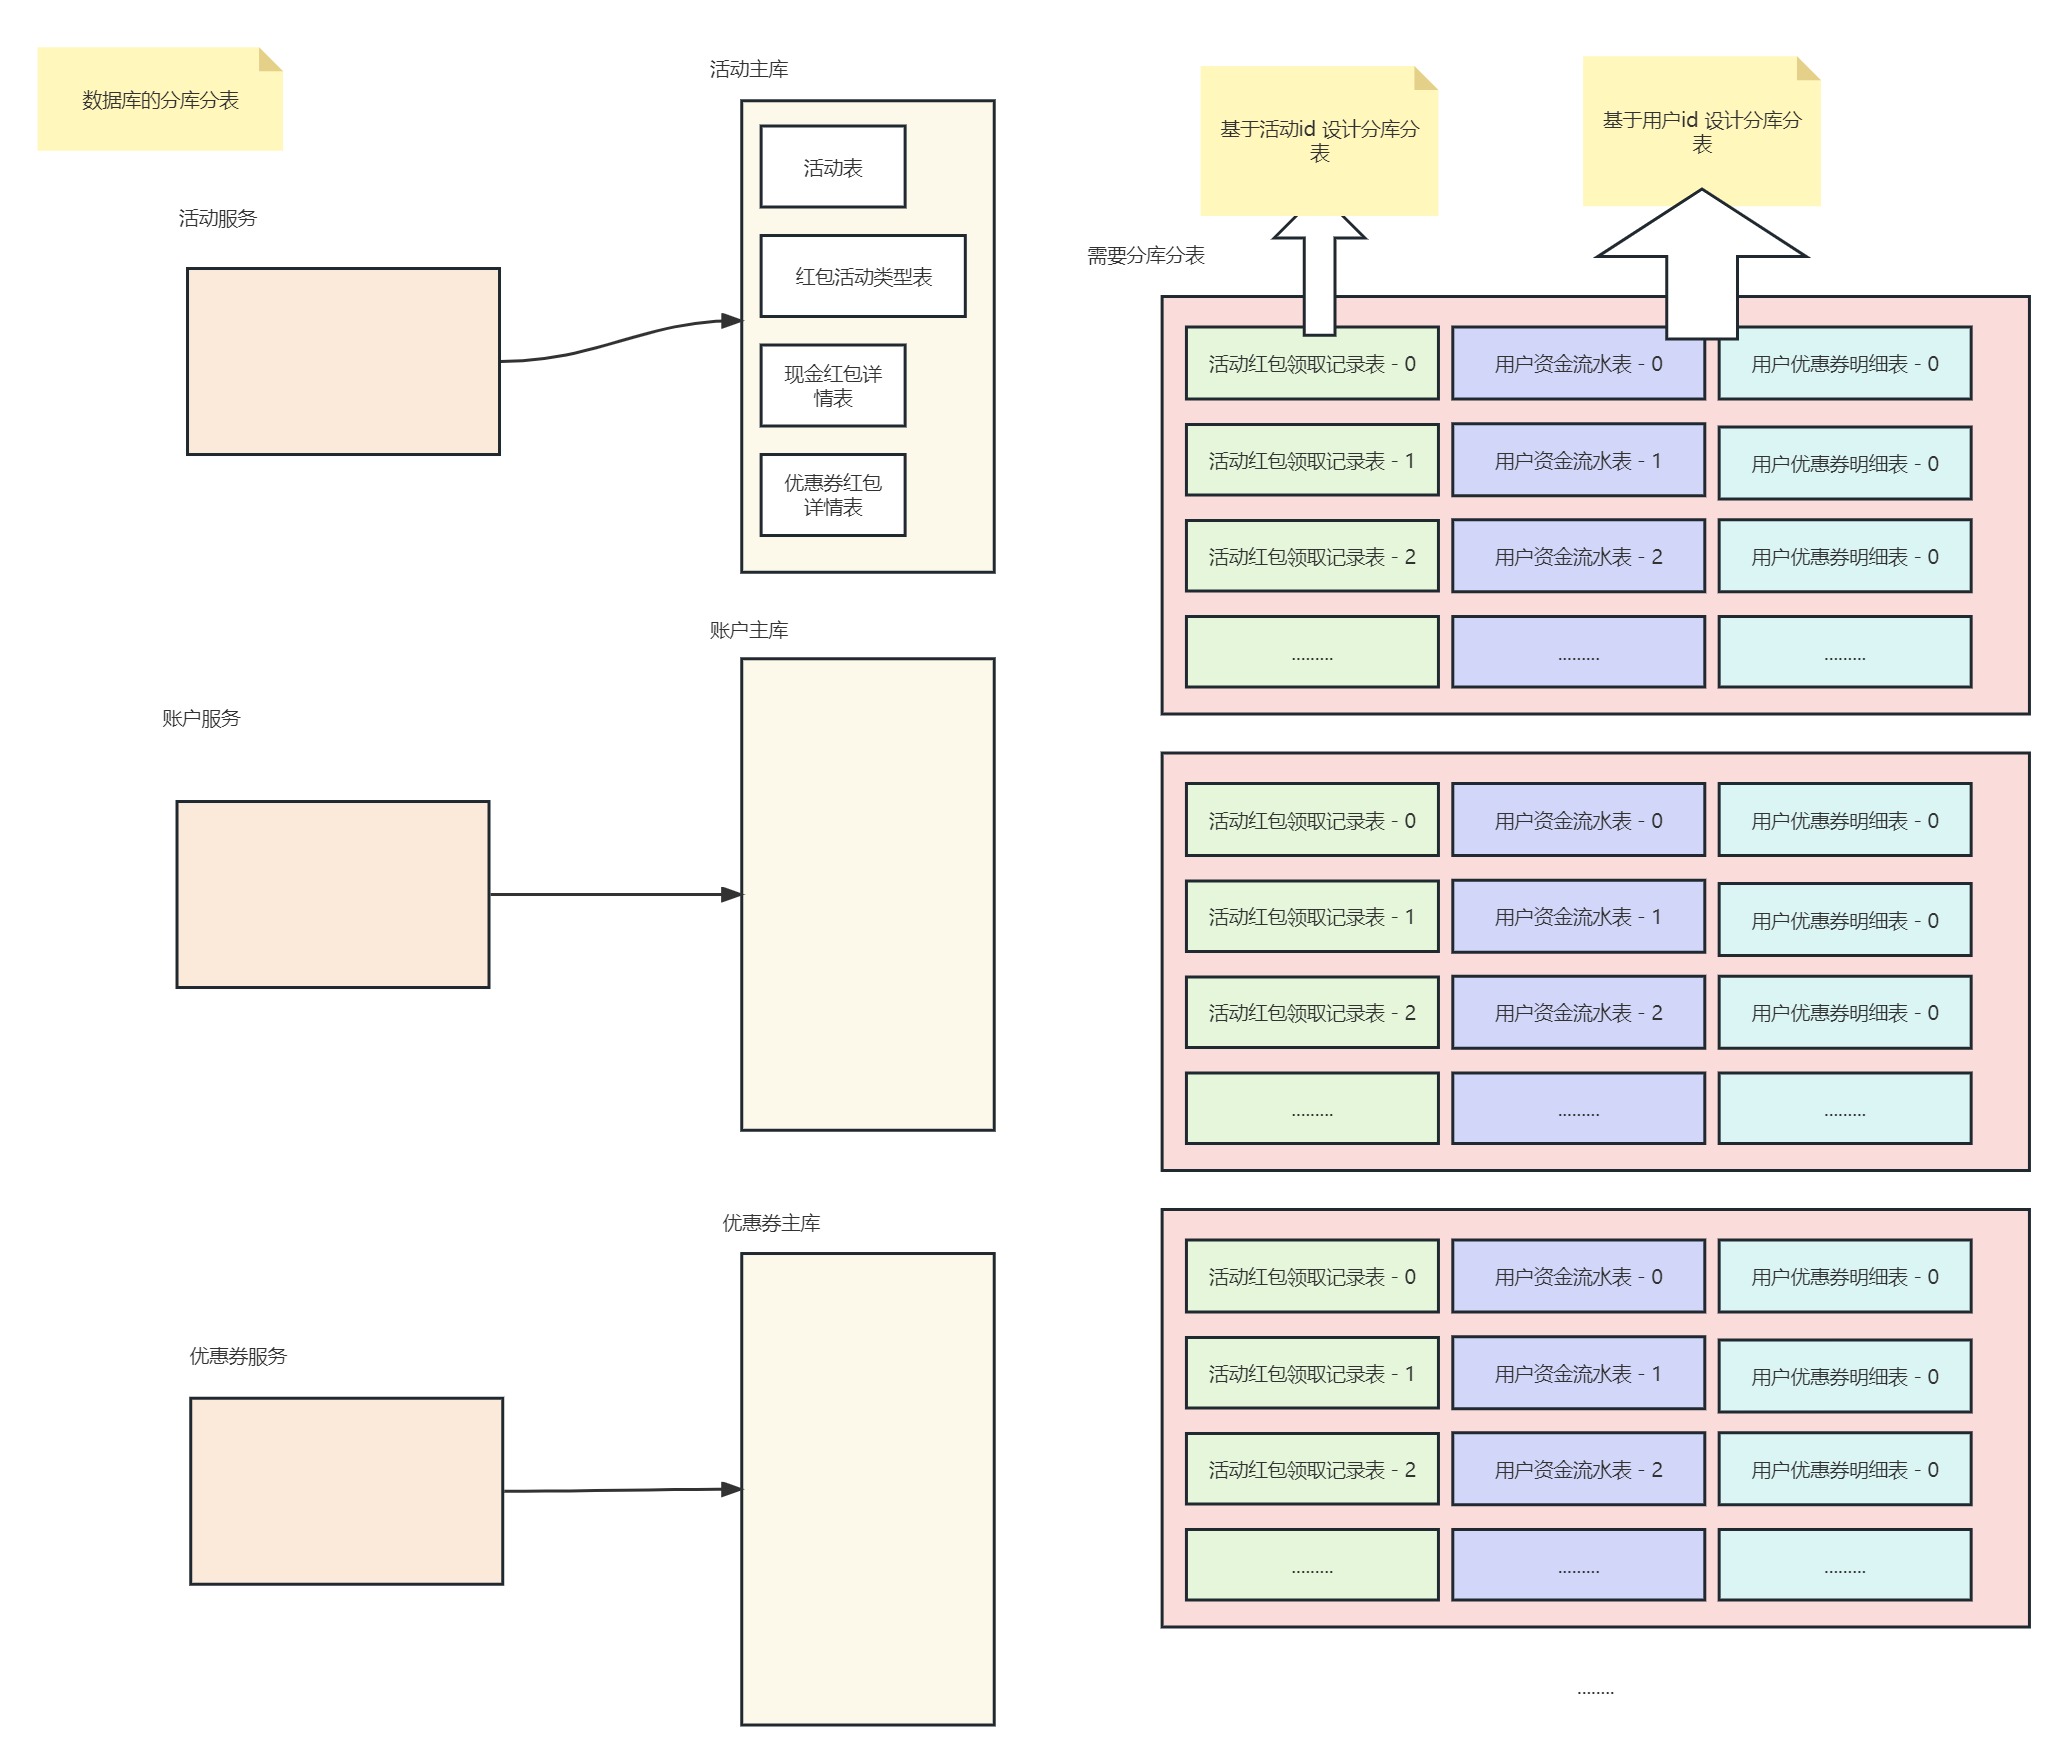
在简历上的Xxxxx项目中,我负责了红包雨活动的设计与实现,其中活动的并发性和用户量都相对比较大,在集中的几十秒中,会有几十万的请求到达服务器,同样也会产生大量的红包领取记录和用户流水明细的信息。为了保证后续的服务器性能,这块当时进行了分库分表处理。整个项目中我们会有一个主库,核心的表都时存放在主库中的以单库单表的形势存储,另外还有两个拆分库,主要用来存放可能会有海量数据的业务表的。其中红包雨的领取记录表,用户的资金流水表,用户优惠券关联明细表等等都是存放在这两个拆分库中的。就拿活动来说,活动的准备阶段,因为数据量并不大,都会直接操作主库存储查询。活动开始后,相关的请求产生的记录比较大,就会往两个拆分库中存储。比如当用户领取到一个优惠券的红包后,就会将领取信息放入到相应的库的相应表中,另外还要生成一条关联记录。具体的实现,是采用Sharding-JDBC的完成的,活动领取记录会基于活动id来分库分表,规则是用活动id的个位数模上库的数量,用十位数模上表的数量,确定库表的位置,这样可以保证同一个活动的所有相关记录会放到同一个库表中,为了后续活动统计分析时,方便查看某个活动的相关明细。而用户优惠券的关联记录,需要以用户为准,所以是基于用户的id用相同的方式确定库表的位置,为了方便基于用户的角度查询自己名下所有的优惠券以及使用情况。这就是当时我们项目中分库分表的具体设计实现。
4.5 高拓展性优惠券模块设计
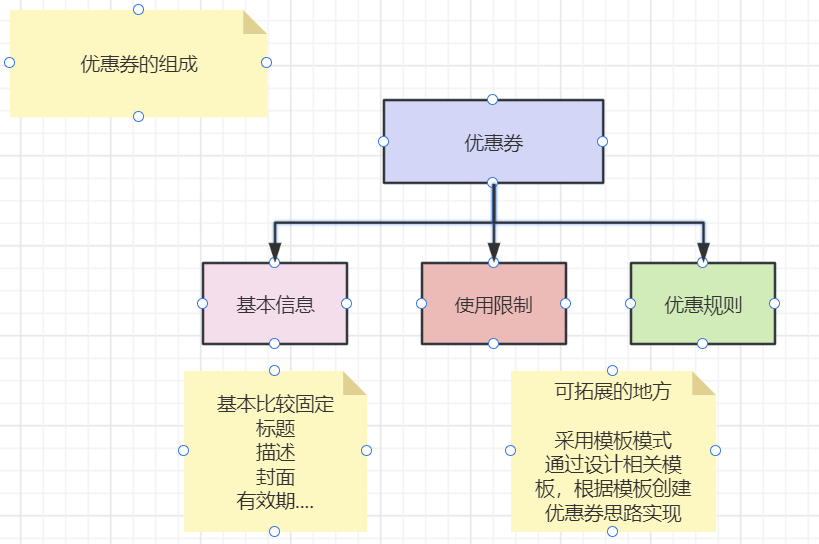
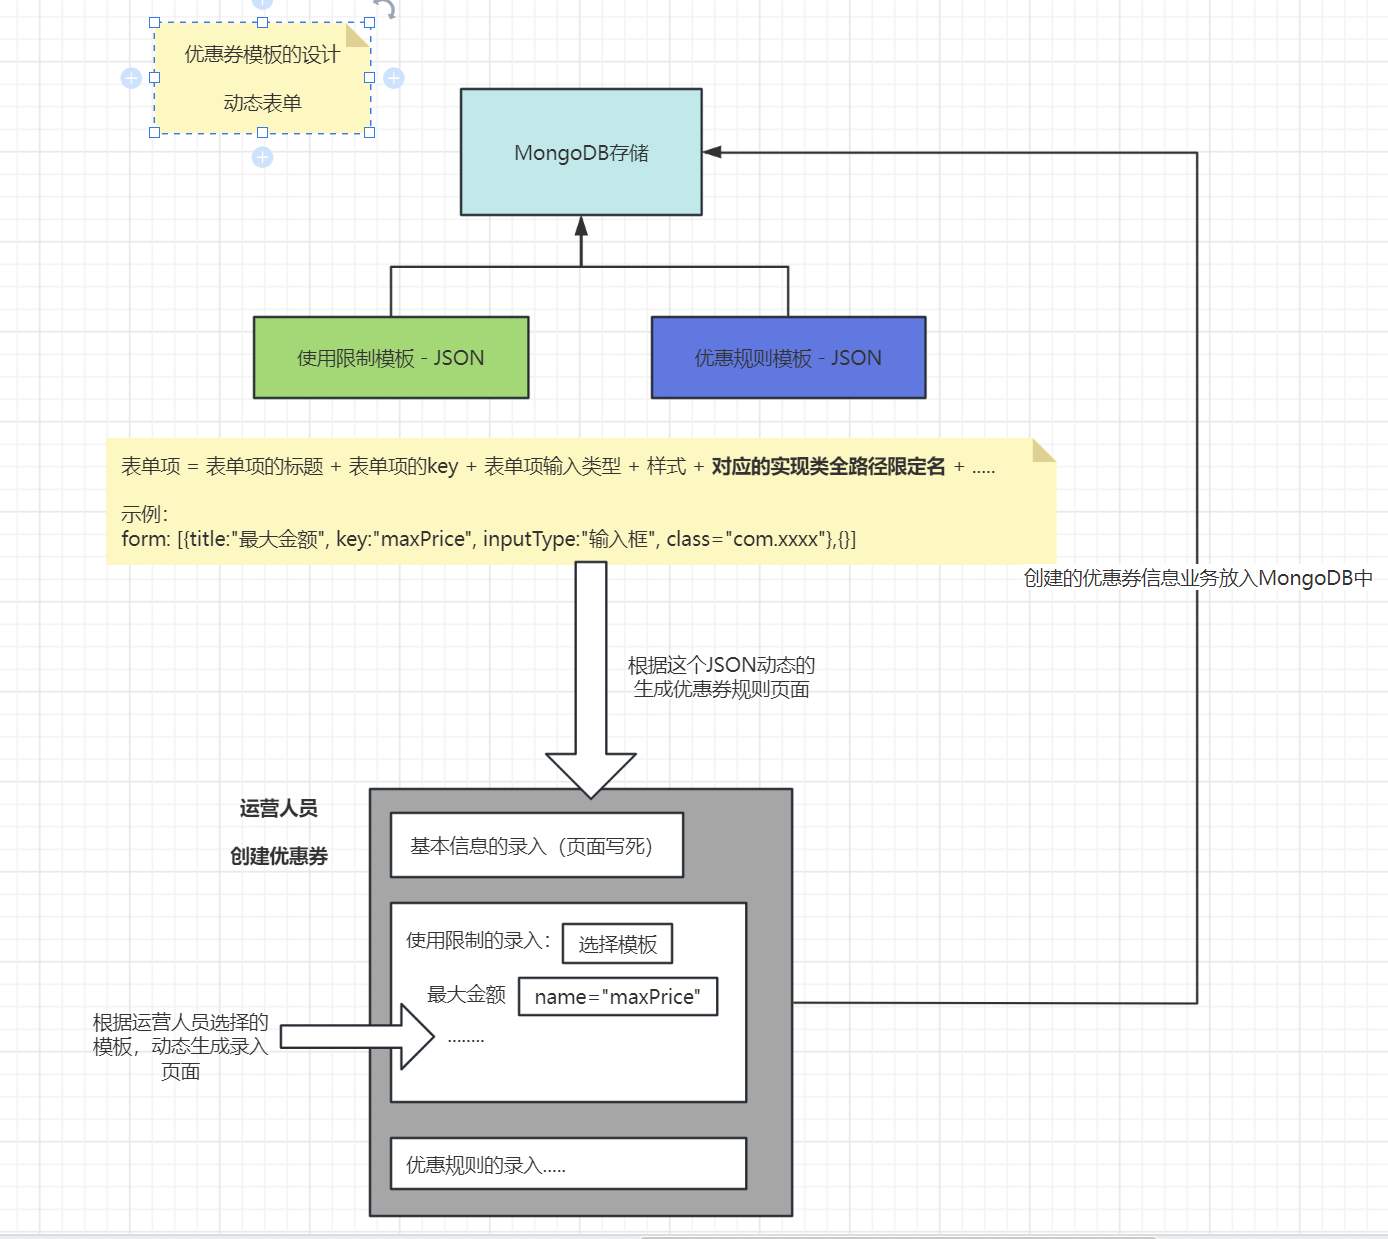
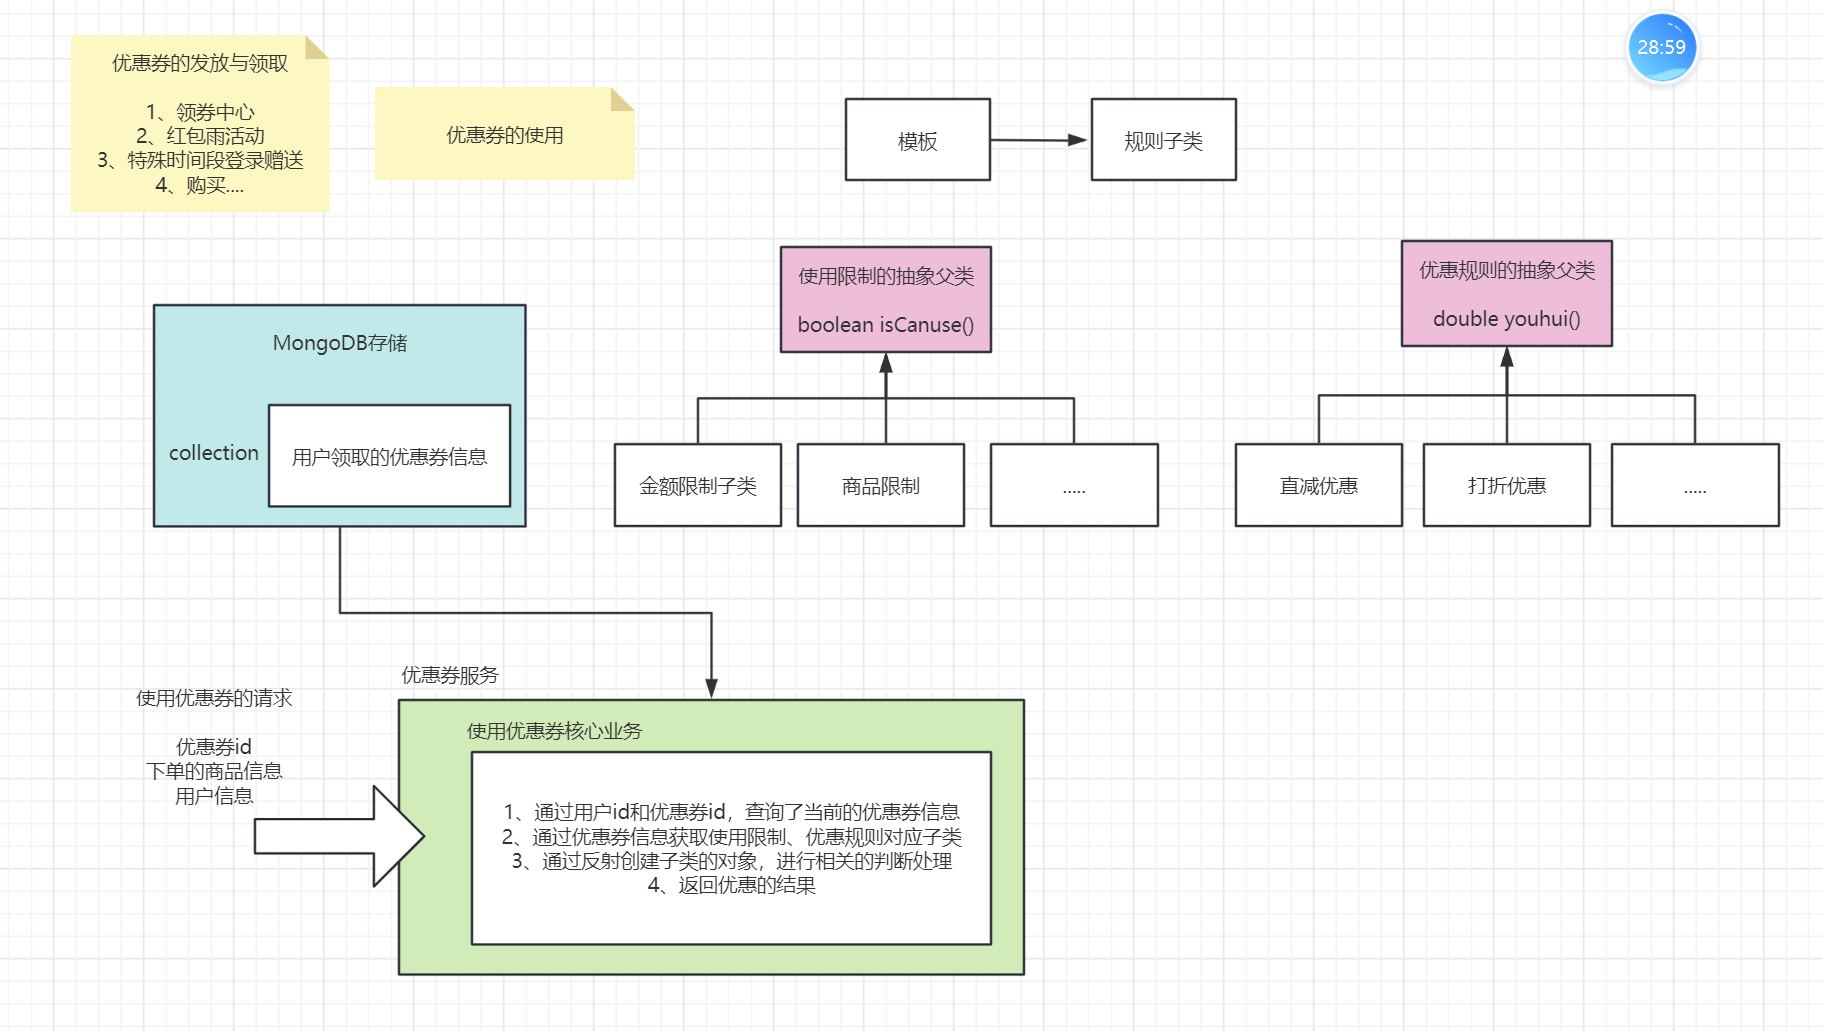
简单描述下曾经设计过的一个优惠券的模块,当时公司的项目需要进行全面重构,我主要负责优惠券模块的重构与设计。原版项目中的优惠券是基于业务逻辑写死实现的,所以优惠券的类型比较单一,很难实现新的优惠券种类的添加,拓展性相对比较受限,每次添加新的优惠券种类时,都需要配套的修改核心业务逻辑。重构时,我就采用了模板模式的思路,将优惠券拆分成三部分,分别是基本信息和使用限制以及优惠规则。每种优惠券的基本信息基本一致,在数据库中写死即可,相对来说,优惠券的使用限制和优惠方式各不相同,这两块是基于规则模板来定义的。重构之后,只需要开发者定义出相关的模板以及模板对应的实现类,那么理论上就可以排列组合出任意的优惠券来满足需求。运营人员在构建优惠券时,只需要选择相关的使用限制模板和优惠规则模板,页面会动态生成规则表单项,录入了优惠券的相关信息后,优惠券的信息会保存到MongoDB中,供后续使用。当使用优惠券时,通过优惠券的规则反射生成规则模板对应的实现类,采用多态的形式访问实现模板的具体业务。这样的设计很好的将核心业务代码与优惠券的优惠方式进行了解耦。大致的实现流程就是这样的。
4.6 IOT物联网平台设计
平台整体架构
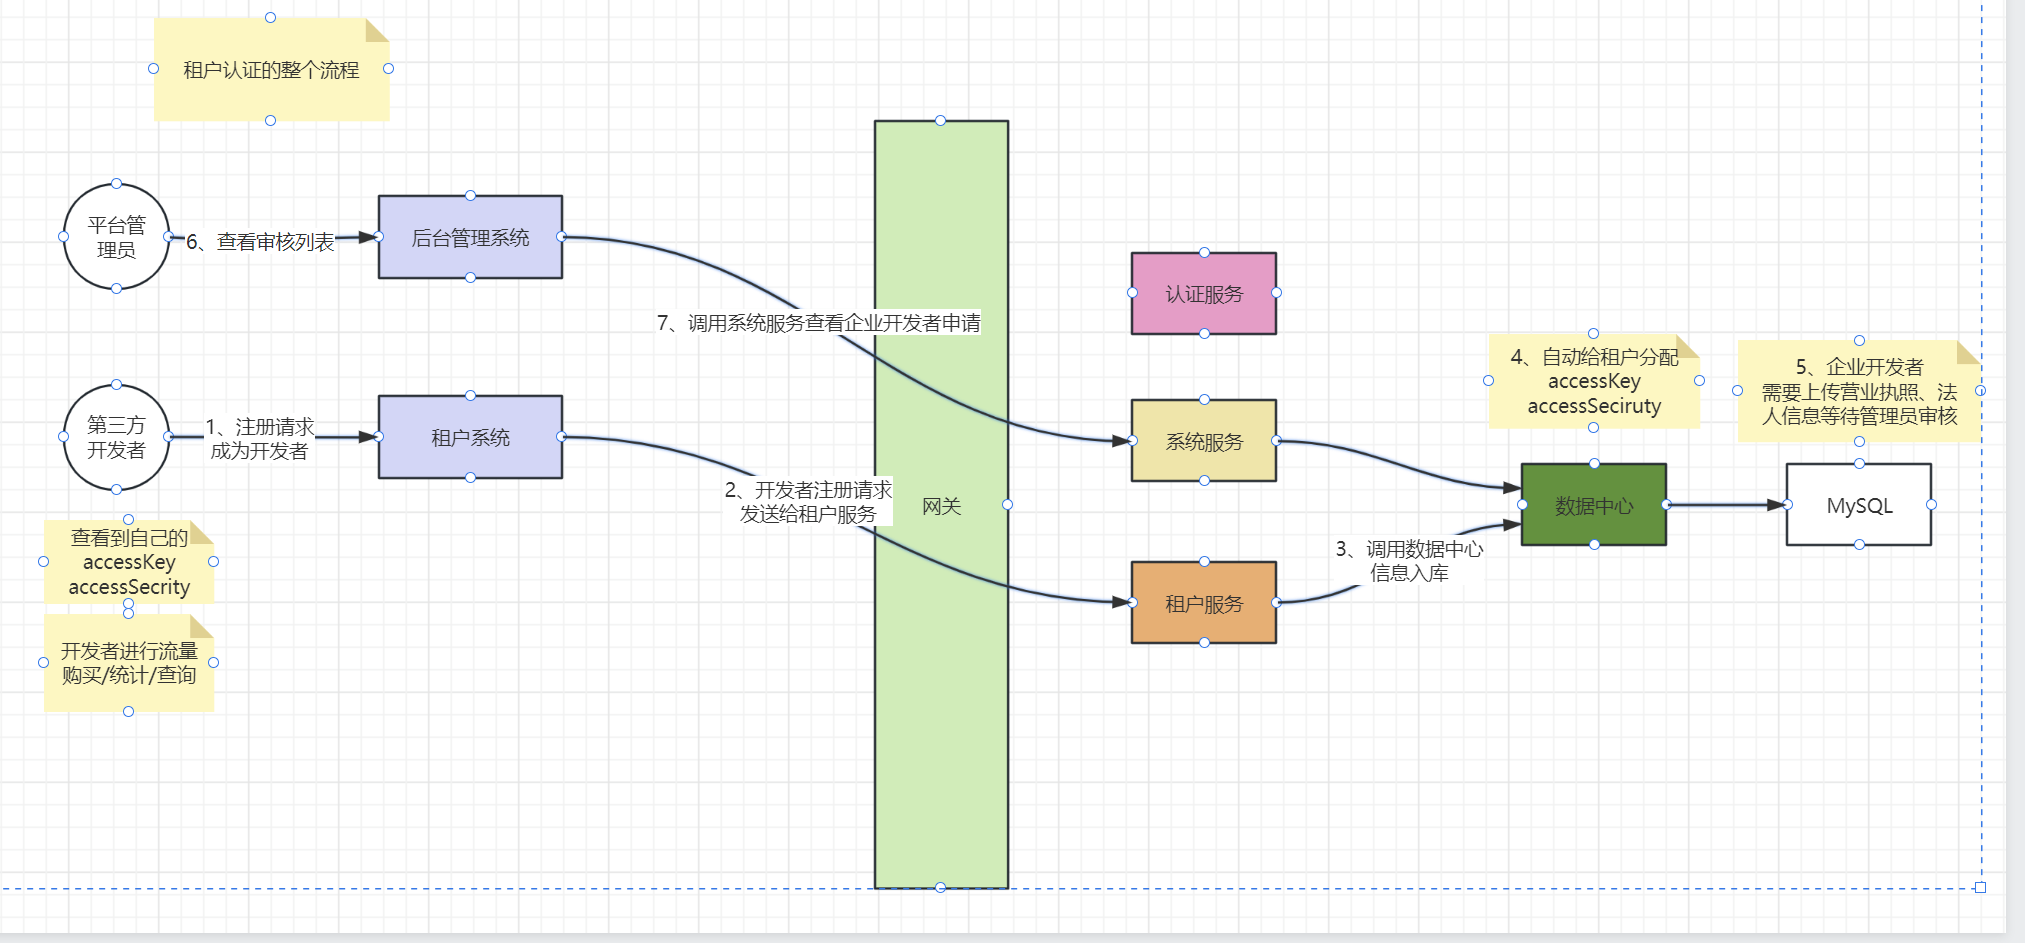
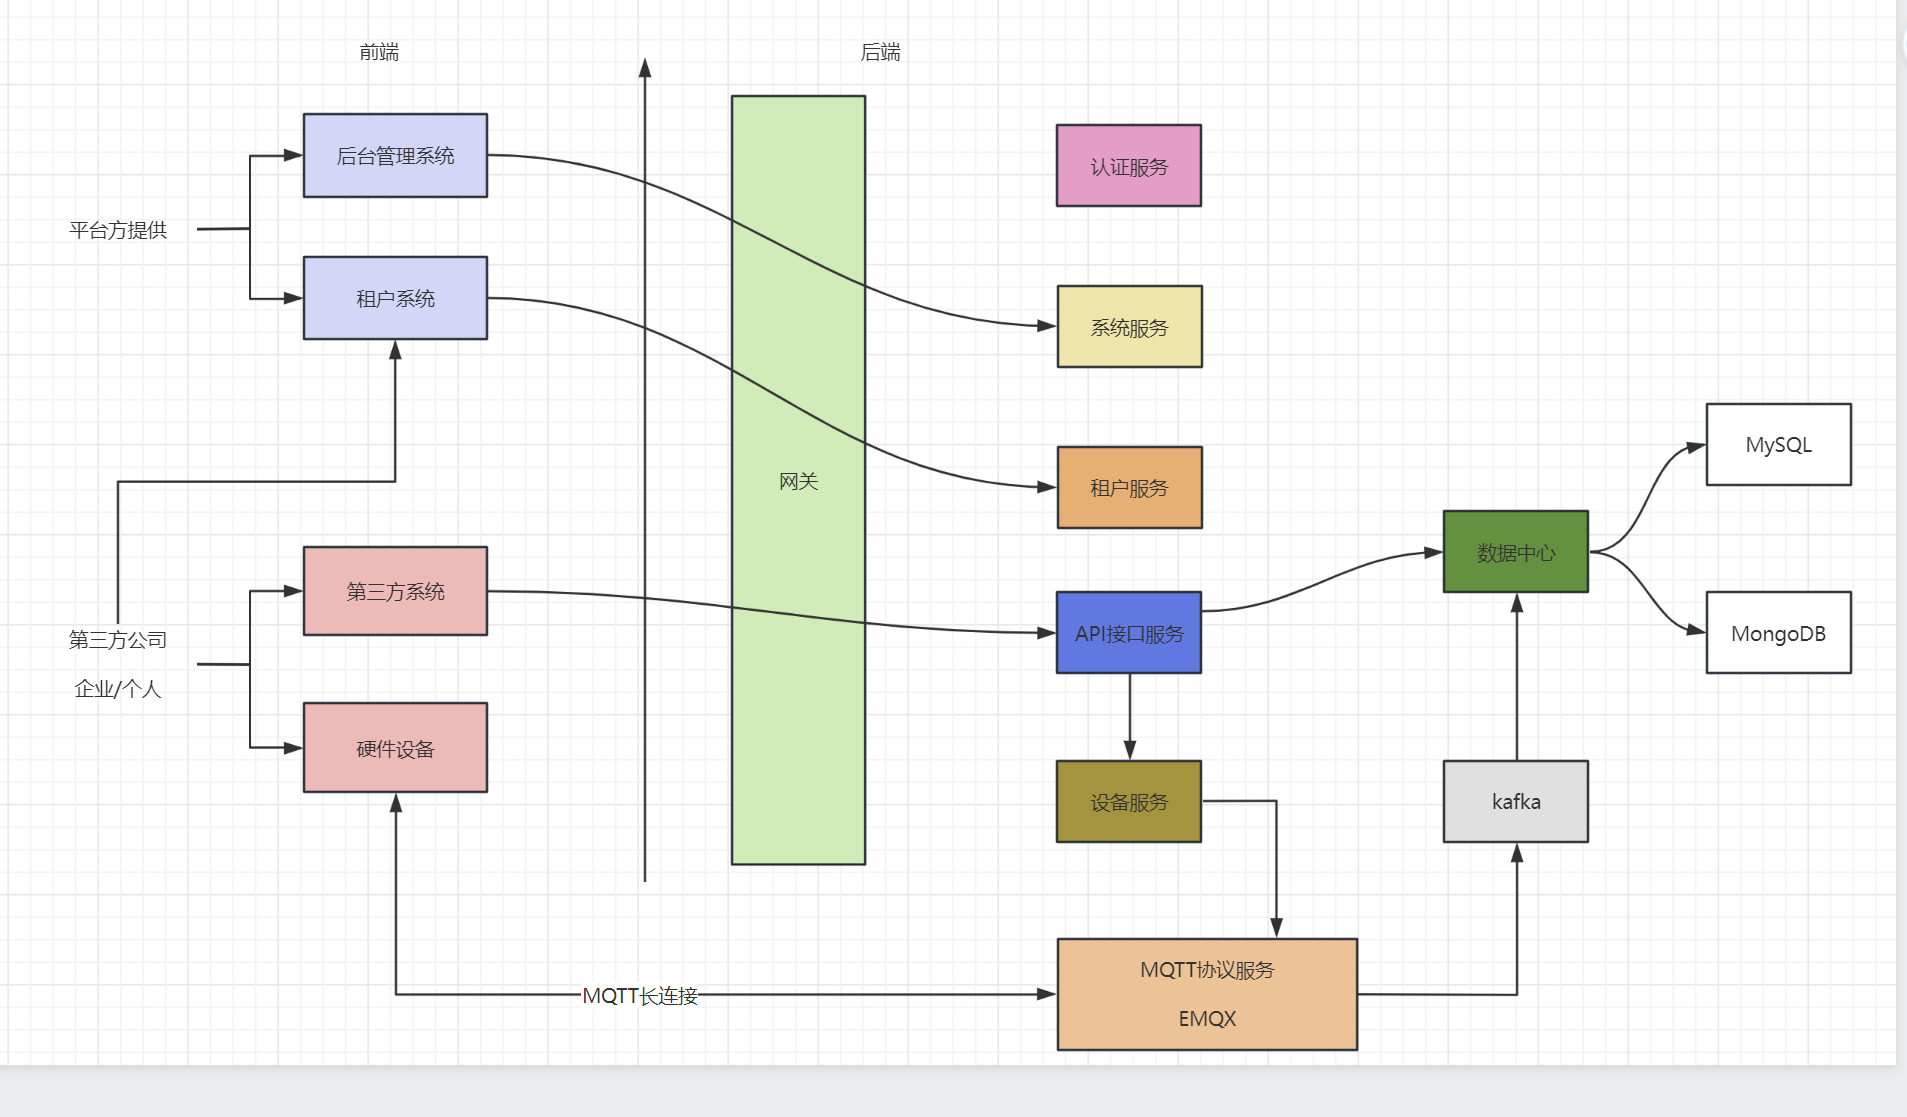 租户认证
 第三方设备管理
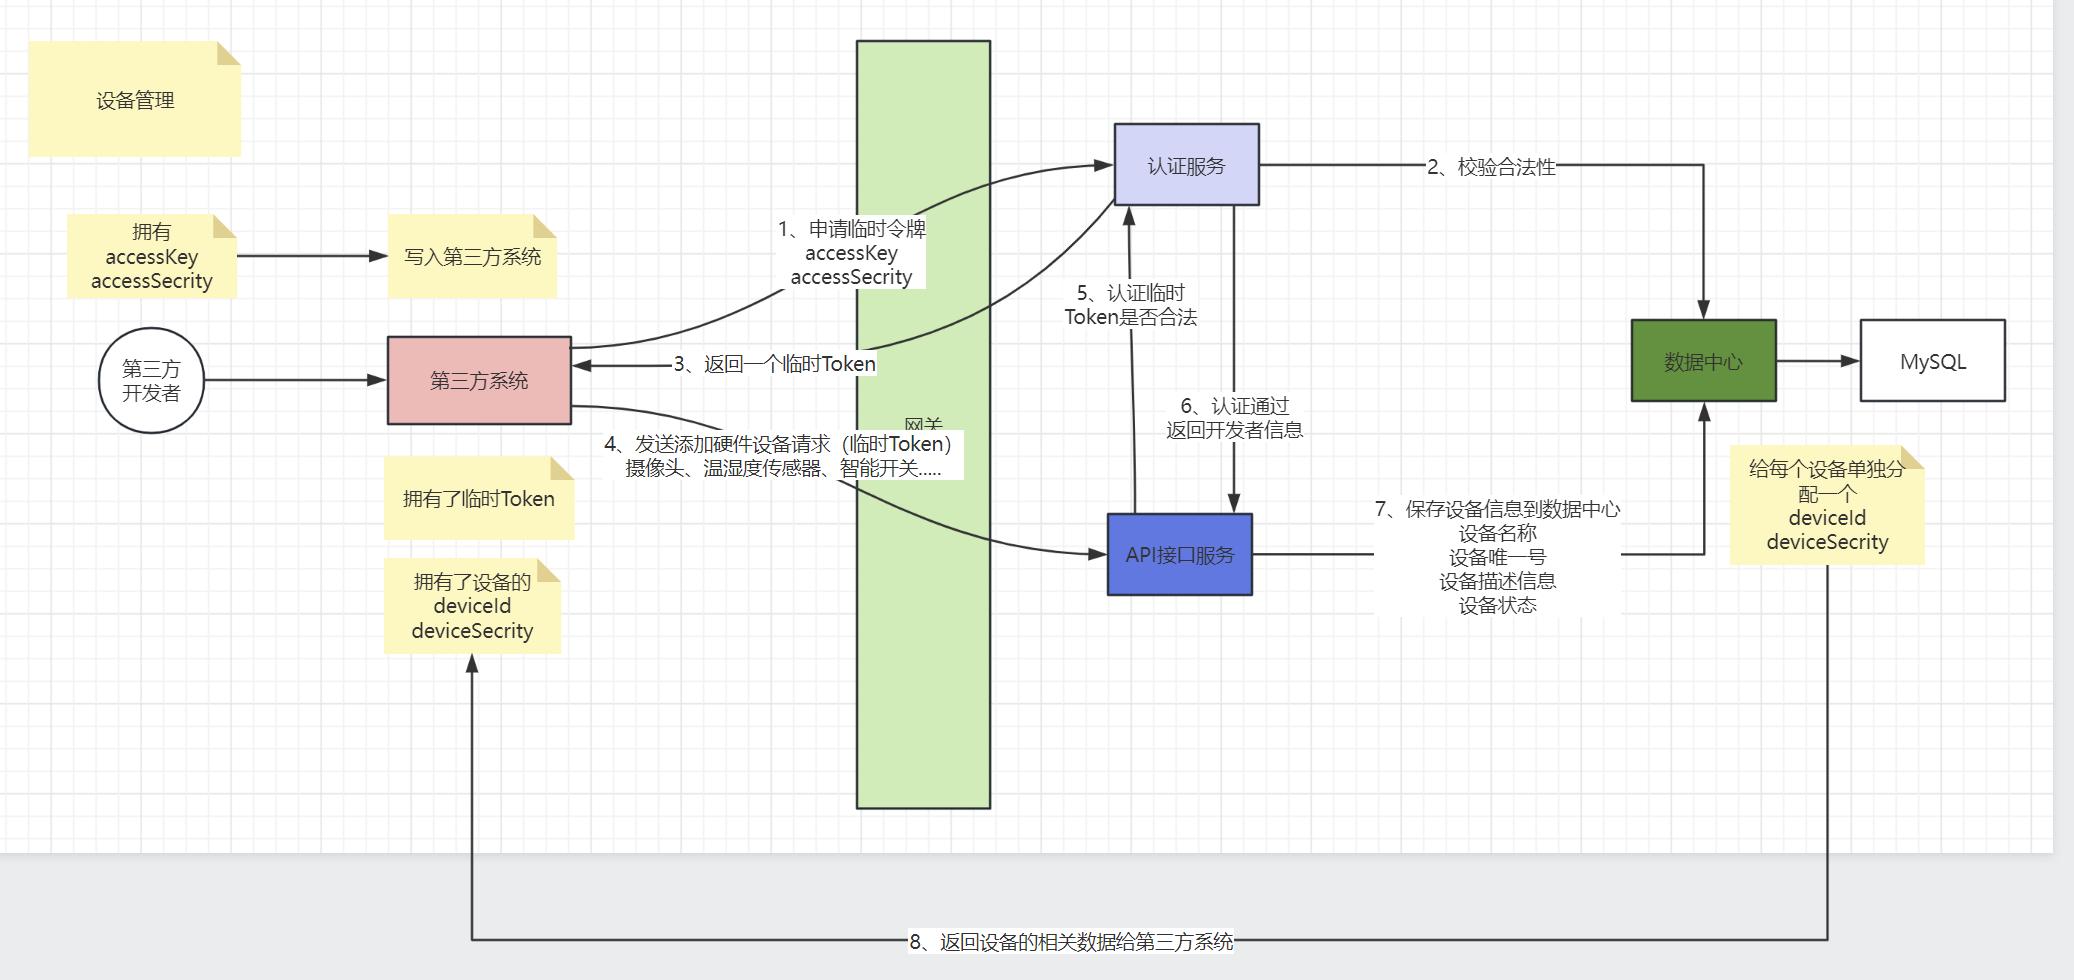 设备认证
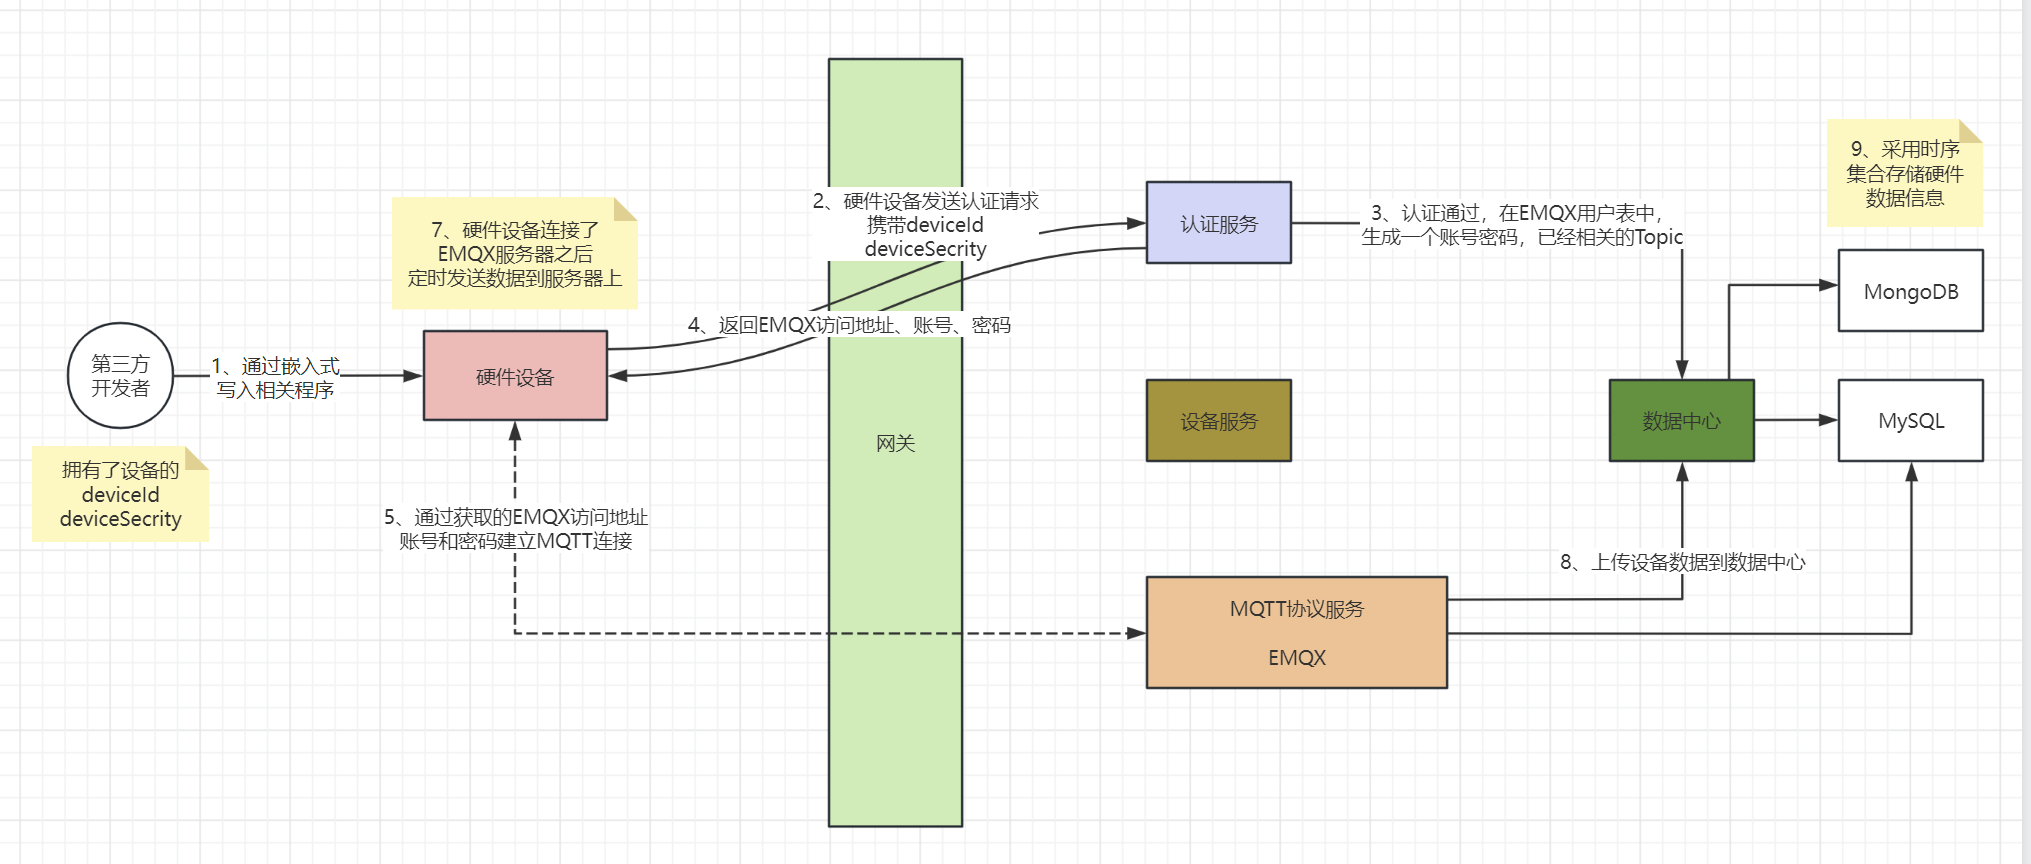 物联网通讯闭环
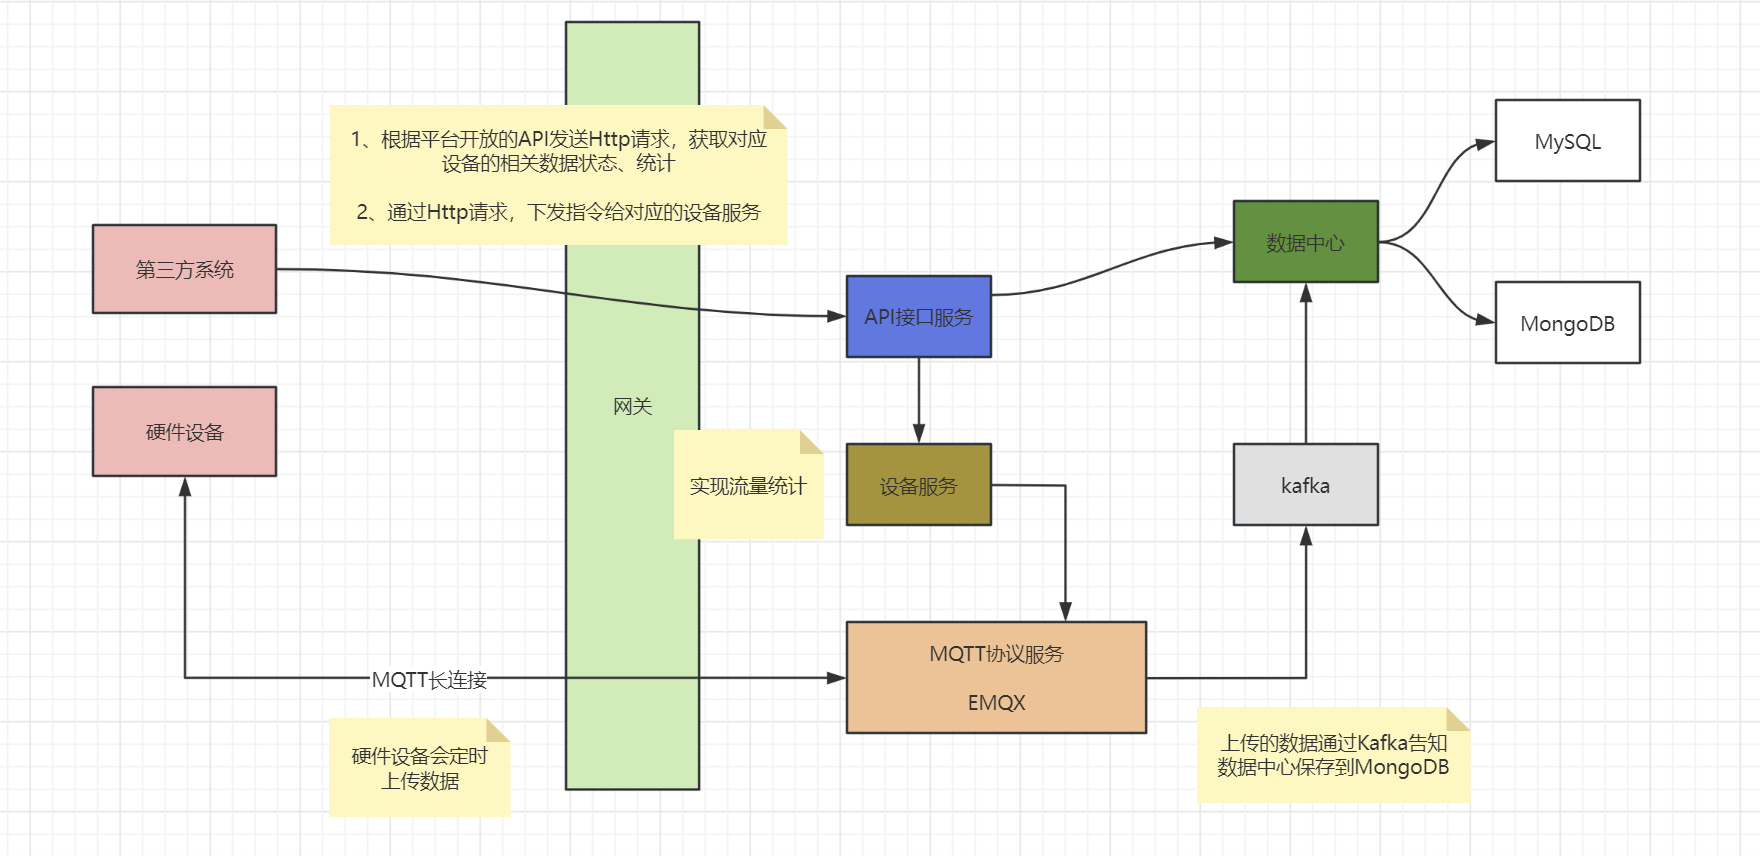
五、其他
5.1 实际工作中的开发流程
- **需求分析 **- 产品经理提出需求《需求概要说明书》、《原型图》
- 设计阶段
- UI人员 - 设计页面、切图
- 测试人员 - 编写《测试用例》
- **开发人员 - **
- 《概要设计说明书 - 业务流程》
- 《详细设计说明书 - UML建模/类图/用例图/E-R图/方案选型/伪代码》
- 《数据库设计》(重要)
- 《接口文档》
- 方案评审
- 代码编写
- **开发人员 - **
- 架构师设计架构(项目初期)
- 开发者按照方案进行代码实现
- 代码评审
- 提交代码到Gitlib(解决冲突)
- 单元测试
- 测试部署
- 运维人员 - 从Gitlib上拉取最新代码,部署到公司的测试服务器上
- 测试人员
- 黑盒测试(功能测试)- 根据**《测试用例》**测试代码功能
- 白盒测试(自动化测试)- 编写一些测试脚本、使用测试工具进行自动化测试、压力测试、边界测试.....
- 开发人员 - 改BUG(禅道 - 软件开发管理系统)
- 上线维护
5.2 进公司之后的大概工作
第一天 - 办理入职手续、签合同,领电脑,装环境,通过git地址拉取代码 第二天 - 想办法运行公司的项目、熟悉公司的项目架构和业务、数据库结构(相对比较难得部分)
- 通过项目名称或者包名,猜测架构中每个模块大致的功能
- 看父工程的pom.xml,了解依赖
- 找项目的业务具体去看
- 询问同事最好有一个测试环境可以访问
- 找领导让他讲解下整个项目的需求业务
- 询问领导后续自己可能负责的部分,或者需要详细了解的部分
- 客户端通过F12了解发送的请求
第N天 - 领取一些边缘性的业务(简单的业务修改、BUG修改)
5.3 面试时实际开发的相关问题
- 项目的数据量有多大
- 不同的表,数据量不同,比如用户表,我们项目差不多有三十万数据量,一些业务表,比如红包领取记录等,有上千万条记录
- 项目的并发量有多大
- 一些并发量高的接口,比如抢红包接口,可以达到每秒3千到4千左右的并发量
- QPS - 每秒查询数
- TPS - 每秒事务数
- 项目部署用了多少台机器
- 3台
- 团队的人数
- 8 ~ 9 个 4个后端 2个H5 1个安卓 1个IOS 2个UI 3个测试 1个运维
5.4 部署的方式
- 单体架构 - 手动部署
- 项目 -> 打成war包/jar包 -> 发给服务器 -> 运行即可(java -jar xxxxxx.jar)
- 分布式架构 - 脚本部署
- 项目 -> 多个jar包 -> 编写一个shell脚本 -> 运行脚本部署
微服务架构 - 自动化部署(jenkins)
5.4 其他面试题
1) ==和equals的区别
==比较的是地址,equals比较的是值 - 错误如果是基本类型,==比较的是值(字面量),equals比较不了基本类型(基本类型不能调方法); 如果是引用类型,==比较的是内存地址,equals的底层默认就是==,比较的也是地址。但是具体比较什么,取决于当前对象如何重写equals方法。
2)equals方法和hashcode方法的关系,为什么重写了equals方法必须重写hashcode方法?
equals()和hashcode()之间的关系
- 两个对象equals()返回true,hashcode()必须相等
- 两个对象hashcode()相等,equals()比较不一定为true
为什么重写了equals必须重写hashcode?
当我们设计一个类时,如果需要重写equals方法,那么原则上是必须要重写hashcode方法的,来保证上面的原则。原因在于,如果当前的类对象有可能作为key放入HashMap的话,则两个equals比较为true的对象,理论上应该放入同一个哈希槽中,但是如果因为没有重写hashcode方法,则这两个对象有可能算出不同的哈希槽的下标,从而导致两个“相同”的key,放入了两个不同的哈希槽中,违背了HashMap的设计原则。
3)static关键字的作用
static是静态关键字,
- 被static修饰的成员,意为“类级别的成员”
- 非static修饰的成员,默认为“对象级别的成员”
- "对象级别的成员"是可以直接调用"类级别的成员"
- "类级别的成员"是不能直接调用"对象级别的成员"
- "类级别的成员"中不能使用this关键字
static关键字可以修饰**:成员变量、方法、代码块、内部类,**分别代表的含义:
- 成员变量:当前变量是类变量,内存地址只有一份,可以通过类直接调用(当前也可以通过对象调用)
- 方法:类方法(静态方法),本质上和普通方法没有什么区别,可以通过类名直接调用,只能访问类级别的成员
- 代码块:类代码块(静态代码块),特点是,当类加载时触发一次,通常用来初始化类变量。
- 内部类:静态内部类,静态内部类和外部类具有一样的特性,可以直接创建(非静态内部类对象的创建必须先创建外部类的对象,通过外部类的对象才能创建非静态内部类的对象)。
4)final关键字的作用
final修饰的成员有最终的意思,可以修饰类、方法、成员变量:
- 类:最终类,不能被继承
- 方法:最终方法,不能被重写
- 成员变量:只能赋值一次,不能被修改(不能再有默认赋值的步骤了)
5)常见的设计模式
- 抽象工厂模式 - SpringIOC
- **单例模式 **- 在实际开发过程中,很少需要自己去设计单例模式的类,一般将类托管给SpringIOC容器,默认就是单例的。(Runtime类、Calendar类)
- 策略模式 - SpringBoot底层创建ApplicationContext容器时,就是采用策略模式。分布式登录,根据不同的登录方式,选择不同的登录业务逻辑,也是采用策略模式
- **责任链模式 **- SpringMVC的过滤器链,Netty的ChannelHandler
- 代理模式 - SpringAOP、MyBatis基于xml文件和映射接口生成一个映射接口的代理实现类
- **模版模式 - **HttpServlet模板类、优惠券模块设计
- **观察者模式 - **Spring的Event事件设计、Kafka中间件(跨服务的观察者模式)
- **门面模式 - **Slf4j框架(解耦应用和日志框架)
- 装饰者模式 - IO流
6)Linux常见命令
- ll
- cd
- touch - 创建文件
- vim - 编辑文件
- rm - 删除文件
- tail -f - 查看文件末尾(查看日志文件)
- rpm - 软件安装
- yum - 在线安装
- system start/stop/restart/status xxx - 操作服务
- mkdir - 创建文件夹
- ps - 查看进程
- jps - 查看java进程
- kill -9 - 强制终止进程
- free - 查看内存
- df - 查看磁盘
- top - 任务管理器
- poweroff - 关机
7)数据库的乐观锁和悲观锁
**悲观锁:在程序中显示上锁的步骤,都属于悲观锁 **
- syncxxxxx
- lock
- 分布式锁
- 数据库的锁(表锁、行锁、读锁、写错)
乐观锁:概念锁,本质上不需要开发者显示上锁
- 逻辑处理时,带上判定条件(版本变化、数字的变化等)
- 数据库中往往添加一个version字段来实现乐观锁
8)字节流如何转换成字符流
通过转换流:
- 输入的转换流:InputStreamReader
- 输出的转换流:OutputStreamWriter
对IO的理解
IO流主要是对数据的访问以及输出的操作技术。可以大致分为两大块:
- 对文件的IO的操作(文件流)
- 对网络的IO的操作(Socket)
IO流的分类:
- 方向上的分类:输入、输出
- 类型上的分类:字节、字符
9)如何保证流一定关闭
- 关闭的操作放到finally块中
- try(流的声明) {流的操作}
10)定时任务中,固定速率执行和固定延迟执行的区别
- 固定速率执行 - 表示任务每次触发的间隔时间严格按照配置的时间执行,忽略任务本身的执行时间
- 固定延迟执行 - 下次任务的定时时间,是在当前任务执行结束后再开始计算的。所以每次任务执行的间隔时间 = 配置的定时时间 + 任务的执行时间
11)字节流和字符流的区别
- 字节流就是操作字节
- 字符流就是操作字符,字符流本质上就是特殊的字节流
- UTF-8汉字字符 = 3个字节
- GBK汉字字符 = 2个字节
12)项目为什么用到kafka,为什么用到MongoDB
- 为什么用kafka?因为本身我们这个项目是一个微服务项目,必然涉及到服务间的通讯,除了常用的Feign(同步通讯)之外,往往也需要进行异步通讯,所以一般都需要一款消息中间件。那么常用的消息中间件有RabbitMQ、RocketMQ、Kafka,其中Kafka的特点就是高吞吐量(功能比较有限、实时性相对较低),那么我们这个项目数据量和并发量相对都比较大,所以基于这个原因,在技术选型时,选择了Kafka
- 为什么用MongoDB?MongoDB是一个强事务的文档型数据库,所以很多业务数据可以直接存储到MongoDB中,另外MongoDB查询数据以及存储容量都要高于传统的数据库。另外,MongoDB的字段是比较灵活可拓展的,而当前我们项目中的Xxxxx功能,数据格式是动态且不确定的,因此非常适合保存到MongoDB中。另外MongoDB5.0之后提供了时序集合,有些时间序列比较重要的数据(IOT采集的数据),可以保存到时序集合中,比传统数据库的查询效率要更高。因此选择了MongoDB
13)百万并发场景需要考虑的地方
怎么解决高并发问题?核心思路,能够处理更多的连接,减少单次请求的响应时间,保证服务的可用性。
- 服务器通常是分布式集群方式部署
- 优化服务器(Tomcat、Jetty、JBoss、WebLogic)的线程池配置
- 网关层做好限流控制(根据压测测算出单个接口的并发量,配置限流的参数)
- 优化业务的执行效率(业务复杂度优化、锁的优化、锁细粒度的优化、锁并发性的优化、SQL优化等等)
- 服务与服务之间做好资源隔离(流量控制、熔断降级 - Sentinel)
- 做好数据缓存(多级缓存的设计、缓存预热)
- Redis的lua脚本(将一些高并发的业务的数据,写入redis,通过lua脚本无锁化的安全操作redis中的数据)
- Kafka的请求削峰(异步化的处理大量业务数据)
14)mybatis底层原理
Mybatis的底层其实就是JDBC。大致的执行流程就是:
- SqlSession对象基于映射xml和映射接口,结合JDK动态代理,生成映射接口的代理实现类,执行SQL语句。
- 代理实现类中的4大内置对象:Exceutor、StatementHander、ParamterHandler、ResultSetHandler
- Exceutor主要负责SQL语句的全局执行
- StatementHander主要对应JDBC中的Statment对象
- ParamterHandler主要用来设置参数
- ResultSetHandler主要用来将查询结果集映射的实体类中(ORM)
15)mybatis如何防止SQL注入
使用#{}设置参数就可以防止SQL注入
在mybatis中#和$的区别
#{}在最终生成的sql中会被替换成? ${}在最终生成的sql中会直接拼接进去
16)mybatis中一对多、多对多和一对一的实现方式
<!-- 对一 -->
<association property=""></association>

<!-- 对多 -->
<collection property=""></collection>
17)set和map的区别
set底层就是依靠map实现的。比如HashSet底层就是new一个HashMap,放入HashSet中的元素,其实都是放入了HashMap的key中而已。
18)springmvc中mvc分别指的是什么?
Model(模型层)- 业务与数据(Service、Entity...) View(视图层)- 展示数据的地方(JSP) Controller(控制层)- 接收请求响应结果的地方,换句话说,也就是和前端进行交互的类(Controller类)
19)linux项目部署用过哪些?
我们公司采用的是Jenkins + Docker全自动化部署的方式,具体是运维搭建的。我自己也有在虚拟机中搭建过,做过一些小的应用的部署测试。在实际开发过程中,部署的整个流程都是由运维负责,不需要开发者过多干预。
20)springboot注解有哪些?分别有什么用?核心注解有哪些?
- @SpringBootApplication 启动类注解
- @EnableAutoConfiguration 自动装配的启用注解
21)如果不是依赖注入,如何管理对象
可以自己仿照SpringIOC实现一个Bean工厂来管理对象
22)说下mybatis的分页是如何实现的,不使用注解
自己写了一个分页插件实现的,要源码吗?地址发给你,记得点个Star
23)生成环境中,如果出现了问了,应该如何排查?
我们原来的公司会采用Skywalking监控微服务集群,当出现一些指标问题时,会及时报警(通过发邮件或者发短信)通知运维或者开发人员进行相关问题的分析。 一般我的排查思路,首先确定问题的接口,然后根据问题出现的时间,查询相关微服务的日志,获取其中的链路追踪号,去ELK系统中,根据链路追踪号搜索相关的所有微服务的日志记录情况,让后根据日志的流程进行排查,从而分析出问题的原因,只有分析出了原因才能针对性的解决相关问题。对于一些性能问题,我们也可以借助Skywalking的性能剖析模块,进行栈追踪分析,从而定位的问题的代码行,进行解决。大致的思路就是先定位再分析再解决。 当然具体的问题还是需要具体的分析,实际开发过程中,不同的问题定位以及解决的方案肯定会不一样。